AGIラボでは以前、判定特化型AI「Jev」をご紹介しました。メールの自動仕分けや回答判定など、長文テキストを生成するのではなく「必要な判断のみ」を高速かつ低コストで返す特化型モデルです。
このJevの競合として、2026年10月1日にCloudflareから「Clef」および「Clef Flash」が新たに公開されました。
Clefシリーズの大きな強みは、テキストに加えて画像入力にも対応している点です。「画像まで扱えるなら、すべてJevから移行すべきでは?」と検討されている開発者やビジネス担当者の方も多いのではないでしょうか。
そこでAGIラボでは、同一の日本語テキストを用いてこれら3モデルを計600回テストし、さらに同一画像を5パターンの解像度で送信して、処理速度・利用コスト・画像認識の挙動を多角的に検証しました。
結論からお伝えすると、今回の検証環境では以下のような結果となりました。
1問のみの単発処理:Clef Flash(中央値)が最速
40問の一括処理:Jevが最速かつ最安
画像の直接判定:Clefシリーズが有力な新たな選択肢
ただし、「処理速度」と「判定精度」は切り離して評価する必要があります。今回の検証は主に処理速度とトークン消費量(コスト)に焦点を当てており、モデルの総合的な精度ランキングを決定づけるものではありません。この前提を踏まえ、実際の測定データを見ていきましょう。
1. Clefとは? Jevと同じ「判定特化型AI」、さらに画像入力にも対応
Clefは、Cloudflareが公開した判定特化型のAIモデルです。一般的なチャットAIのように長文を出力するのではなく、事前に定義した質問に対して構造化された決まった形式で回答を返します。
Noul:「この問い合わせは緊急か?」などの二者択一(Yes/No)の確率
Choice:「経理・技術・営業のどこへ振り分けるか?」などの選択肢判定
Score:「重要度は何段階中いくつか?」などの段階評価
判断材料を「state」、質問内容を「questions」として指定する基本構造はJevとほぼ共通しており、すでにJevを使っている人にも試しやすい構成です。
モデルサイズは、標準版のClefが27B(270億パラメータ)、軽量版のClef Flashが9B(90億パラメータ)となっています。いずれもCloudflare Workers AI上で利用でき、モデルの重み(ウェイト)はApache 2.0ライセンスでオープンに公開されています。テキストのみに対応するJevとの決定的な違いは、画像入力に対応している点です。
なお、Cloudflareのモデルカタログ上では、Clefシリーズは「Cloudflare-hosted」、Jevは「Third-party」と分類されています。ただし、東京リージョンのWorkerから呼び出した場合でも、推論を実行するGPUが物理的に東京にあるとは限りません。今回の検証で確認できているのは、あくまで「呼び出し元のWorkerが東京(NRT)であった」という点にとどまります。
出典:Cloudflare公式発表/Clef仕様/Clef Flash仕様/Jev仕様
2. 公式ベンチマークでは? 品質と速度を分けて見る
ここで、Cloudflareが公表した評価結果も見てみましょう。以下はCloudflareによる測定で、この後に紹介するAGIラボの実測とは別のデータです。
品質:得意な課題はモデルごとに異なる
公式ブログの品質評価から6項目と、業務別の評価4項目をまとめました。accuracyは正答率、case exactはケース単位の完全一致、macro-F1は分類ごとのF1を平均した指標、nDCG@10は上位10件の検索順位の良さを表します。指標が違うため、行をまたいで点数を平均したり、すべて正答率として読んだりはできません。
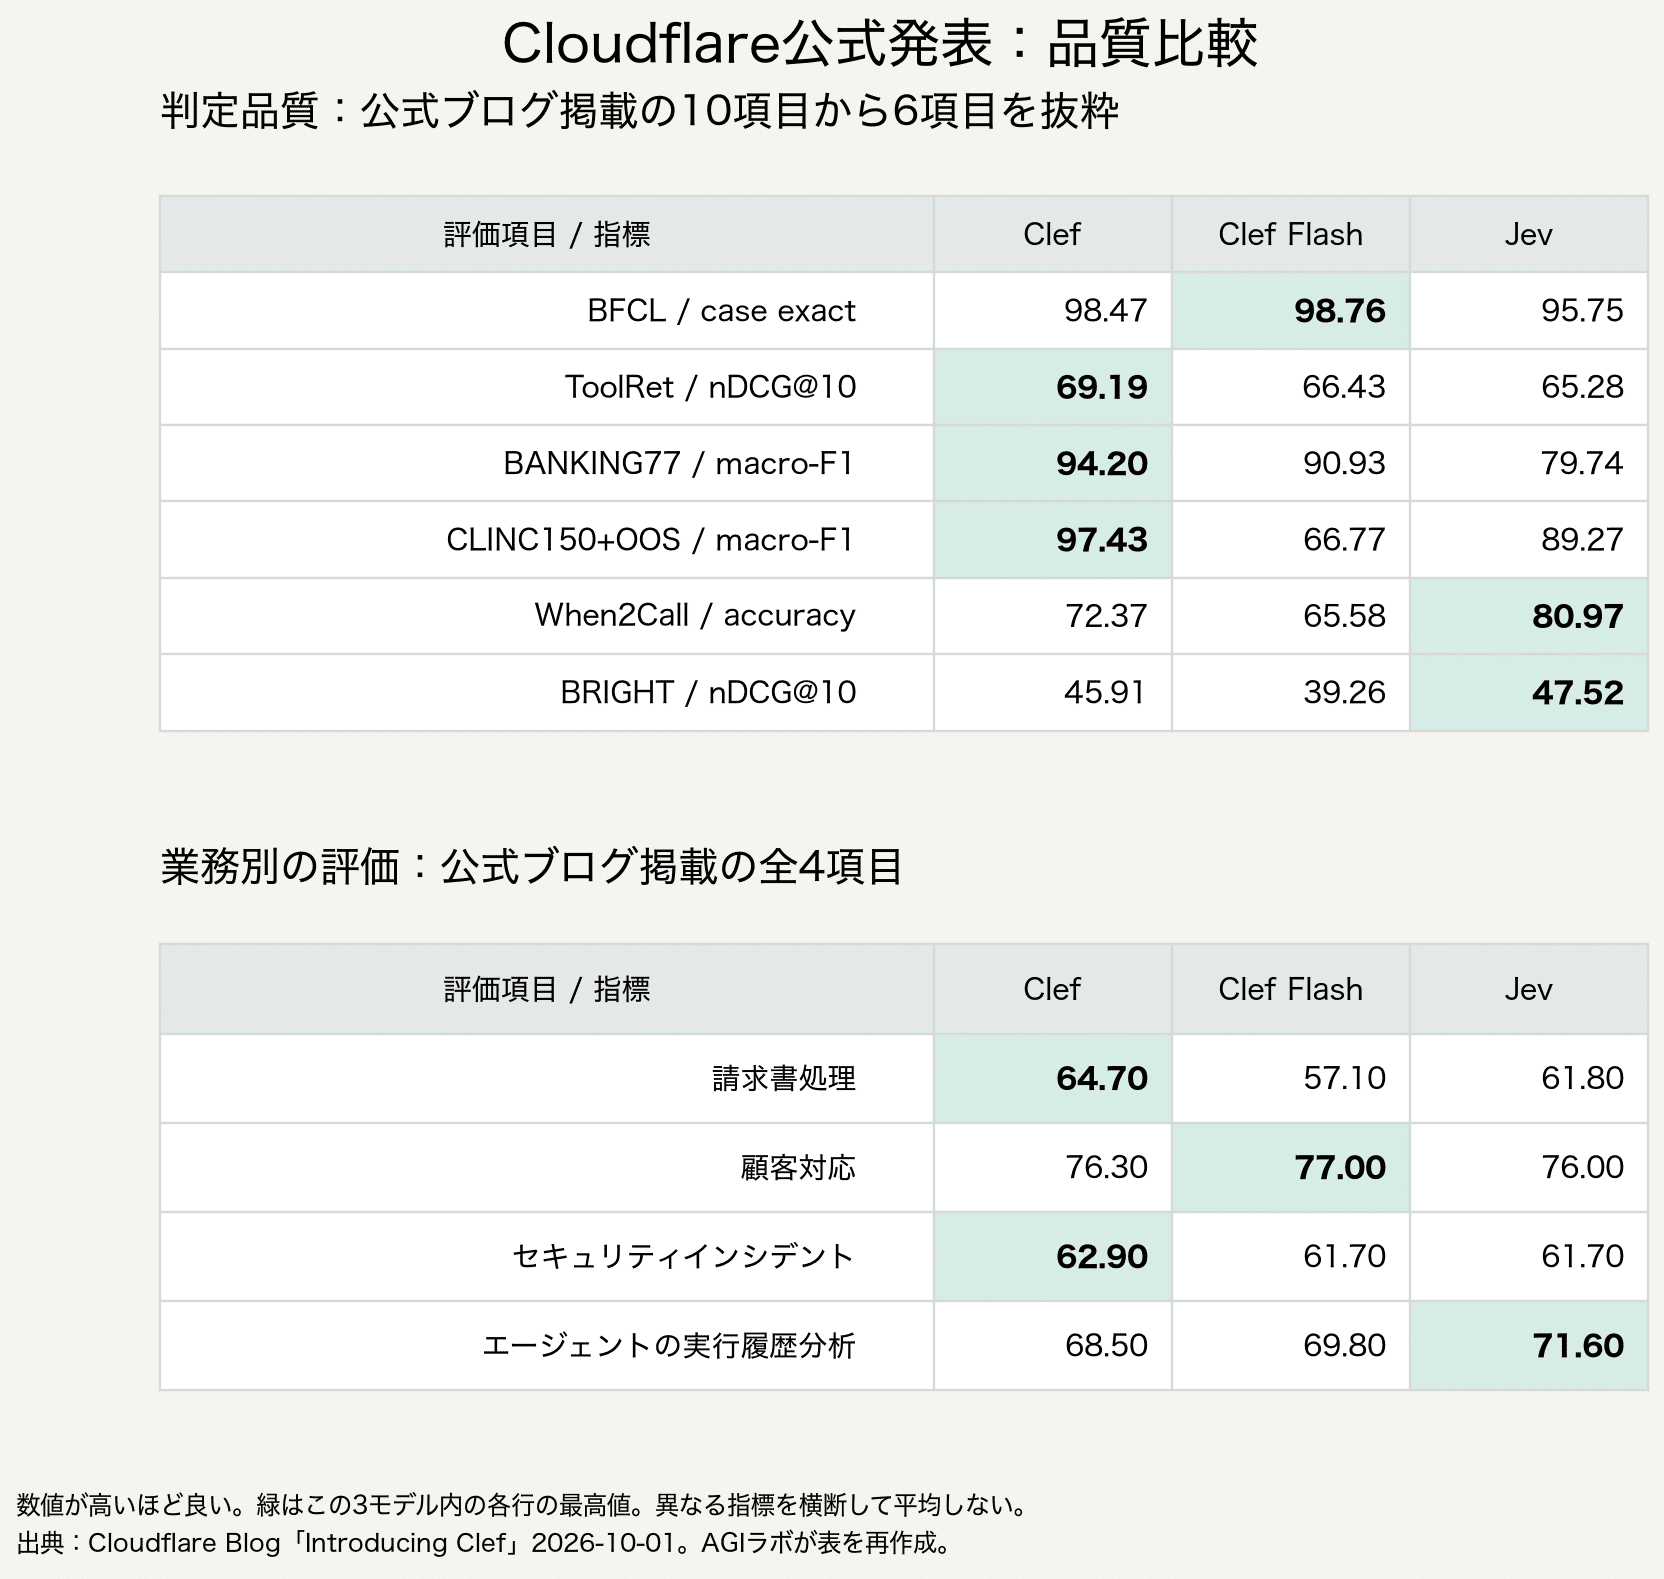
たとえばCLINC150+OOSではClefが高得点ですが、When2CallとBRIGHTではJevが上回っています。業務別でも、請求書処理はClef、顧客対応はFlash、実行履歴の分析はJevがこの3モデル内で最高でした。これを見ると、Clefの追加料金を払う価値があるかは、判定する内容によって変わると考えられます。
速度:公式ではFlashが速い。今回の実測とは条件が違う
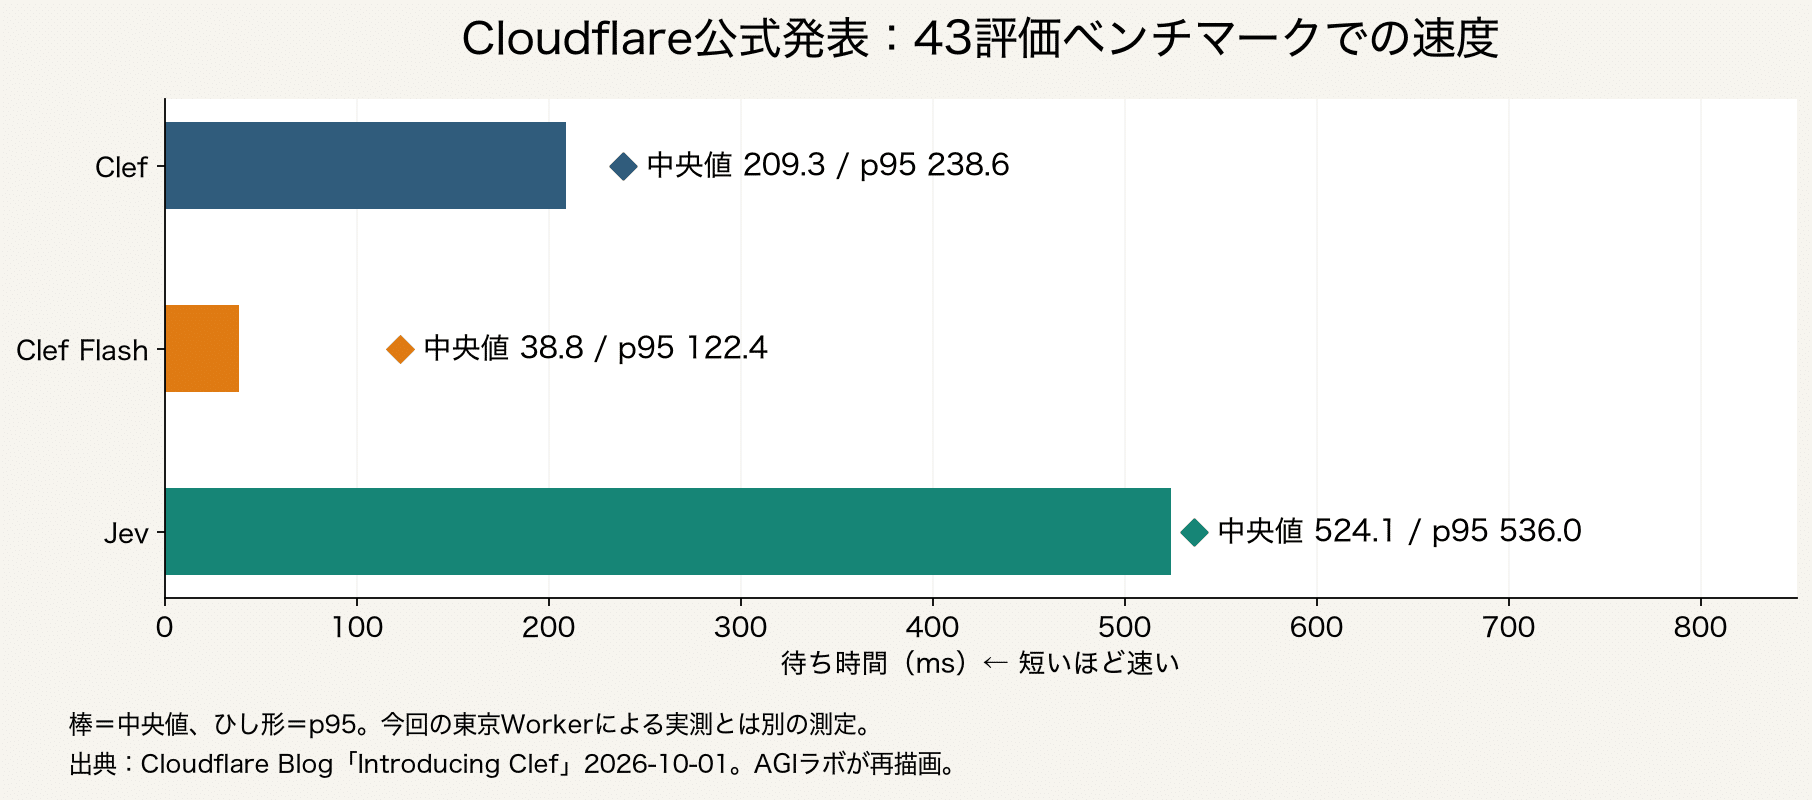
公式ブログが43の評価ベンチマークについて示す中央値は、Clefが209.3ms、Flashが38.8ms、Jevが524.1msです。
一方、後述するAGIラボの日本語40問の実験ではJevが最速でした。この違いには、日本と米国など、呼び出す場所の違いが影響している可能性もあります。今回測ったのは東京のWorkerから結果が返るまでの時間なので、推論先が遠ければ、そこまでの通信時間も含まれます。端末から東京Workerまでの通信時間は含めていません。
ただし、今回のJevとClefが、どちらも米国のGPUで処理されたと確認できたわけではありません。確認できたのは呼び出し元のWorkerが東京(NRT)だったことまでです。CloudflareはClefについて、自社のエッジGPUを利用すると説明していますが、今回の各リクエストの推論場所は分かりません。公式ベンチマークの呼び出し元も、この表からは特定できません。出典:Cloudflare公式発表。
仮に両モデルの推論先が米国だったとしても、通信経路や中継処理が同じとは限りません。一方、両方に同じ通信時間が上乗せされるだけなら、それだけで順位は逆転しません。地理的な影響は考えられますが、「日本から呼んだから」という理由だけでは、今回の順位の違いを説明できません。
入力長、質問数、キャッシュ、混雑状況、測定範囲なども異なる可能性があります。位置の影響を切り分けるには、同じ入力・同じ設定を使って、日本と米国の両方から測る必要があります。現時点では、順位が変わった原因は未特定です。
公式評価はモデルを選ぶ手掛かりになります。そのうえで、自分の入力と実行環境でも測る。この2段階で見るために、ここからはAGIラボの測定結果を紹介します。
出典:Cloudflare公式ブログ(2026年10月1日)。各図は同記事の掲載値からAGIラボが再作成。公式評価デモ/TypeSafeの業務別評価データ。
3. 日本語で計600回検証:入力長と質問数を切り分けた測定設計
予備検証として「短いテキスト」と「長い履歴に対する40問」を比較したところ、処理速度に明確な差が見られました。しかし、これだけでは「入力文が長いから遅いのか」、それとも「質問数が多いから遅いのか」を判別できません。
そこで、要因を正確に切り分けるために以下の4条件を設定しました。
短い履歴 × 1問
短い履歴 × 40問
長い履歴 × 1問
長い履歴 × 40問
テスト用の履歴データには、コーディングエージェントの作業ログを模した合成データを使用しています。「このツール呼び出し履歴は今後も保持すべきか」「出力の全文を残す必要があるか」などを判定させる、コンテキスト圧縮(Smart Compaction)を想定した模擬実験です(実際のユーザーの会話ログは使用していません)。
履歴件数は「短い条件」「長い条件」ともに20件で統一し、各履歴に含まれる出力テキストの長さのみを変えています。stateに渡すJSON文字列は、短い条件で約1,600文字、長い条件で約5,400文字です(ここでの「短い」は本実験内での相対的な表現であり、単なる一言のテキストではありません)。
40問の条件では、APIを40回呼び出すのではなく、1回のリクエストに40問をまとめて渡すバッチ処理を行いました。1問の条件では、その40問の中から同一の1問を抽出して使用しています。
測定は「4条件 × 3モデル × 各50回 = 計600回」実施しました。ラウンドごとにモデルや条件の実行順をランダムに入れ替え、1回ずつ順番に実行しています(各条件2回のウォームアップは測定対象外として事前に実施)。その結果、600回すべての試行で指定通りの形式・件数で判定結果が得られました。ただし、出力フォーマットが正常であることと、判断内容自体の妥当性は別の問題として捉える必要があります。
なお、計測対象は同一の東京Worker内においてAI.run()を呼び出してからレスポンスを受け取るまでの総時間です。ネットワーク通信、キューの待ち時間、推論処理などが含まれた実測値であり、GPU単体の純粋な計算時間ではありません。また、クライアント端末からWorkerまでの往復通信時間は含まれていません。
4. 単発ならFlash、一括ならJev:用途によって異なる速度特性
まずは、通常時のレイテンシを把握しやすい中央値(50回の測定値を昇順に並べた中央の値)で比較します。1,000msが1秒なので、250msなら約0.25秒です。
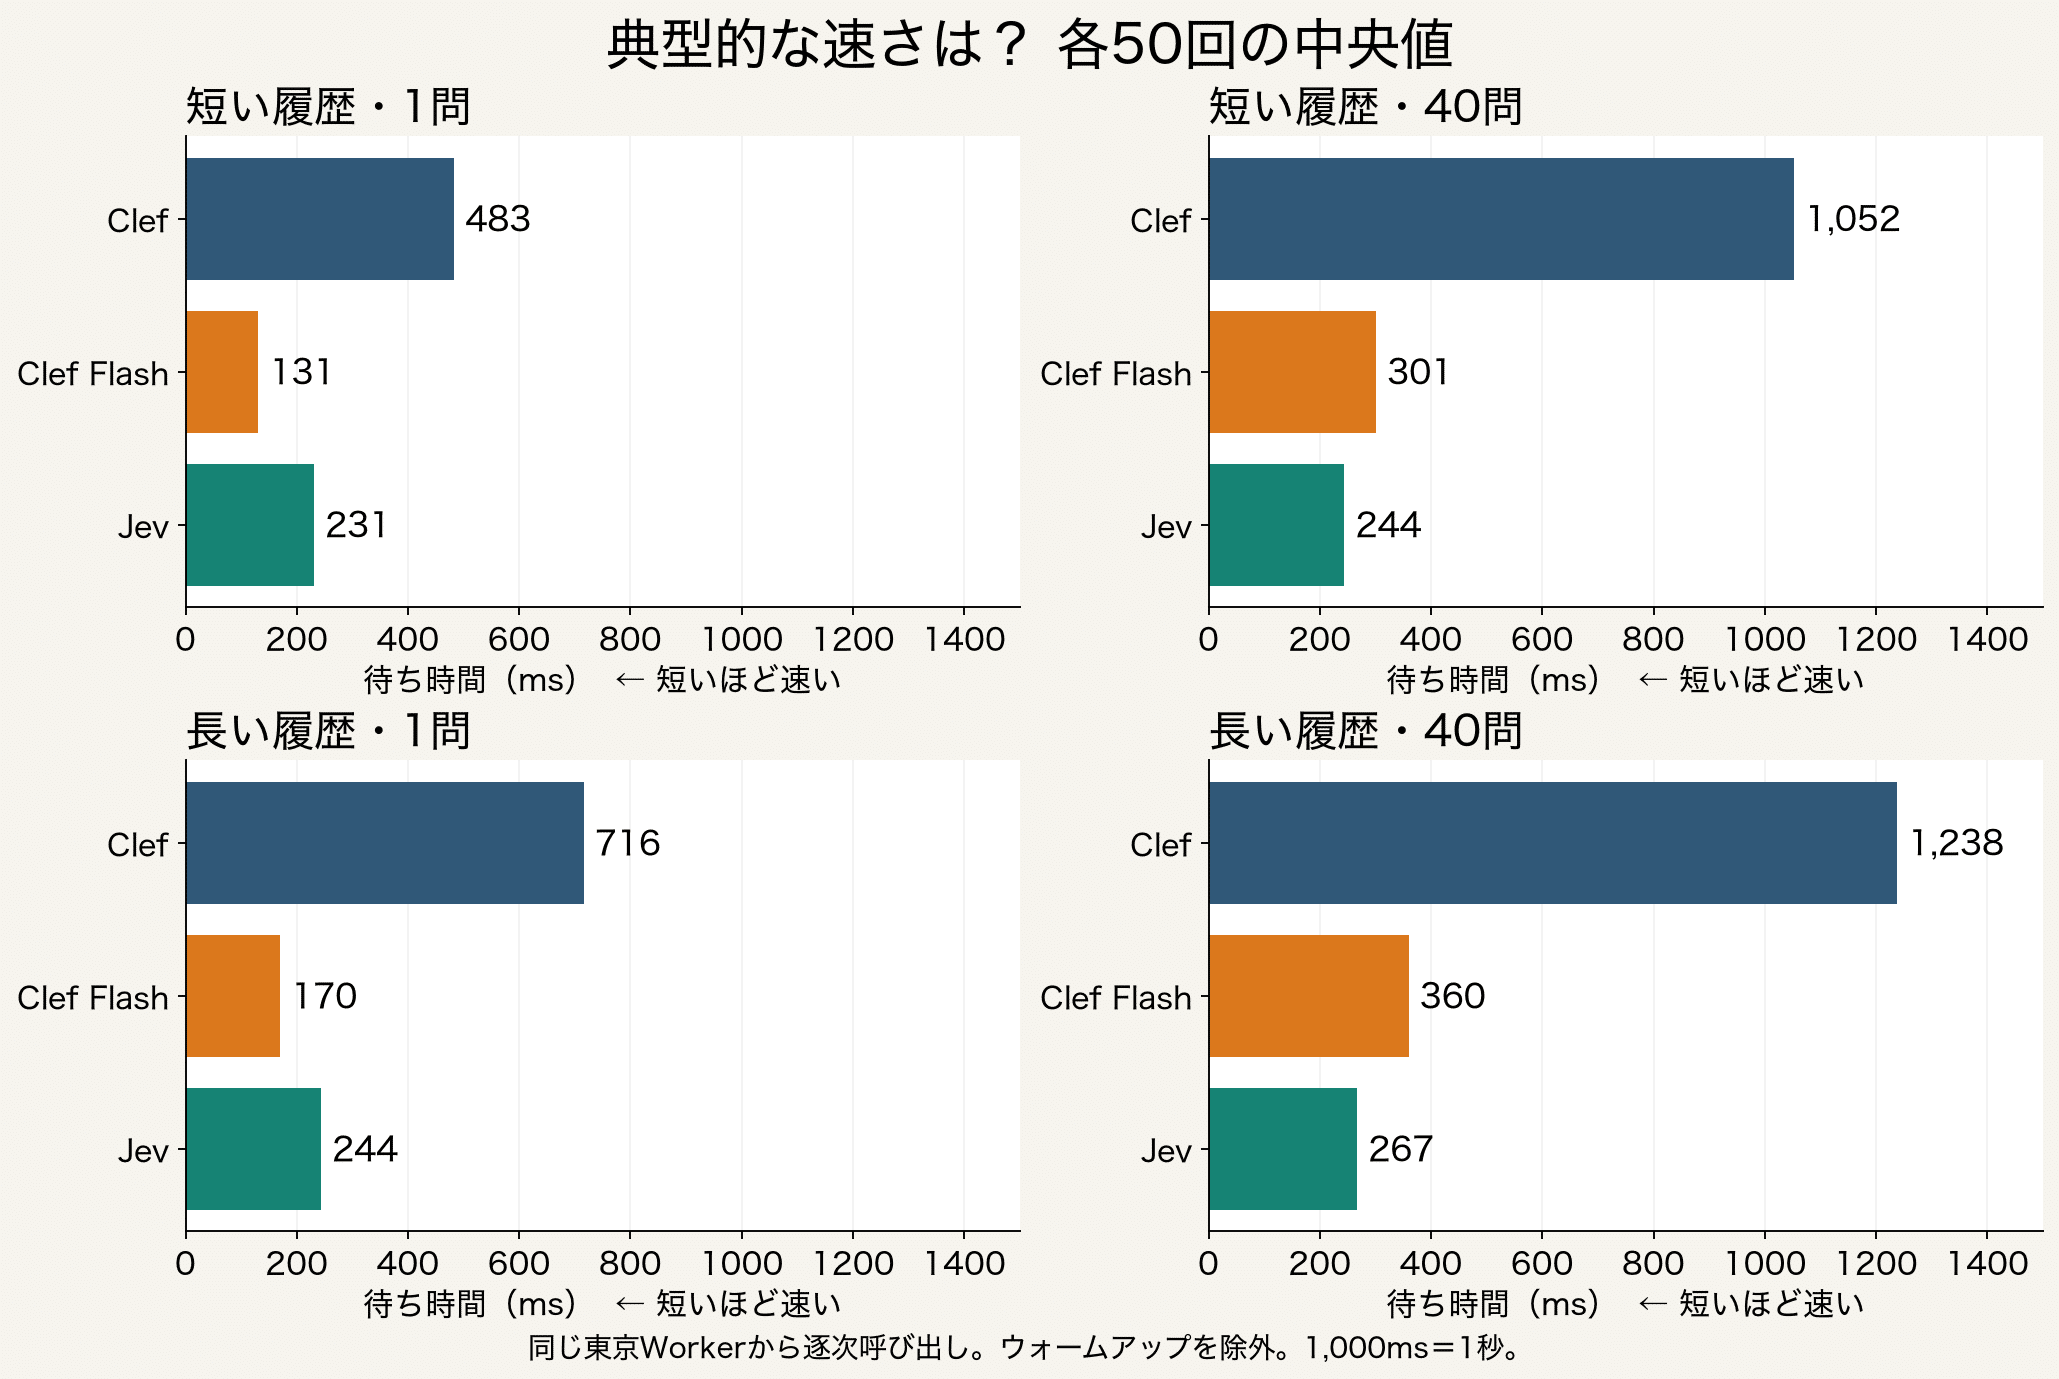
「短い履歴・1問」の条件では、Clef Flashが131ms、Jevが231ms、Clefが483msとなり、Clef Flashが最速という結果でした。
しかし、質問数を40問に増やすと傾向が一変します。「短い履歴・40問」では、Jevが244ms、Clef Flashが301ms、Clefが1,052msとなり順位が逆転しました。「長い履歴・40問」においても、Jevが267ms、Clef Flashが約360ms、Clefが約1,238msとなっています。
特筆すべきは、Jevは質問数を1問から40問に増やしても、レイテンシがほとんど増加しなかった点です。短い履歴の場合、Jevは231msから244msとほぼ横ばいであるのに対し、Clef Flashは131msから301ms、Clefは483msから1,052msへと大幅に増加しました。
この結果から、名前に「Flash」と付いていても、あらゆる条件下で常に最速とは限らないことがわかります。メールを単一の基準で瞬時に分類するような用途と、蓄積された履歴に対して多数の判定を一括で実行するような用途とでは、選ぶべきモデルが異なります。
なお、質問数を40問に増やすと入力プロンプト全体のトークン数も増加します。今回計測できたのはリクエスト全体の待ち時間であり、モデル内部のどの演算処理がボトルネックとなったかまでは切り分けていません。また、公式ベンチマークとは検証環境や入力データが異なるため、数値の単純比較はできない点にご留意ください。
5. レイテンシの安定性と外れ値:「通常時の速さ」と「安定稼働」の違い
システムの性能評価において中央値のみに着目すると、実運用上のリスクを見落とす恐れがあります。今回の検証において、Clef Flash(短い履歴・40問)では50回の試行中2回、約11秒という大きな遅延が発生しました。
全試行の測定結果をプロットすると、その分布特性が明確になります。
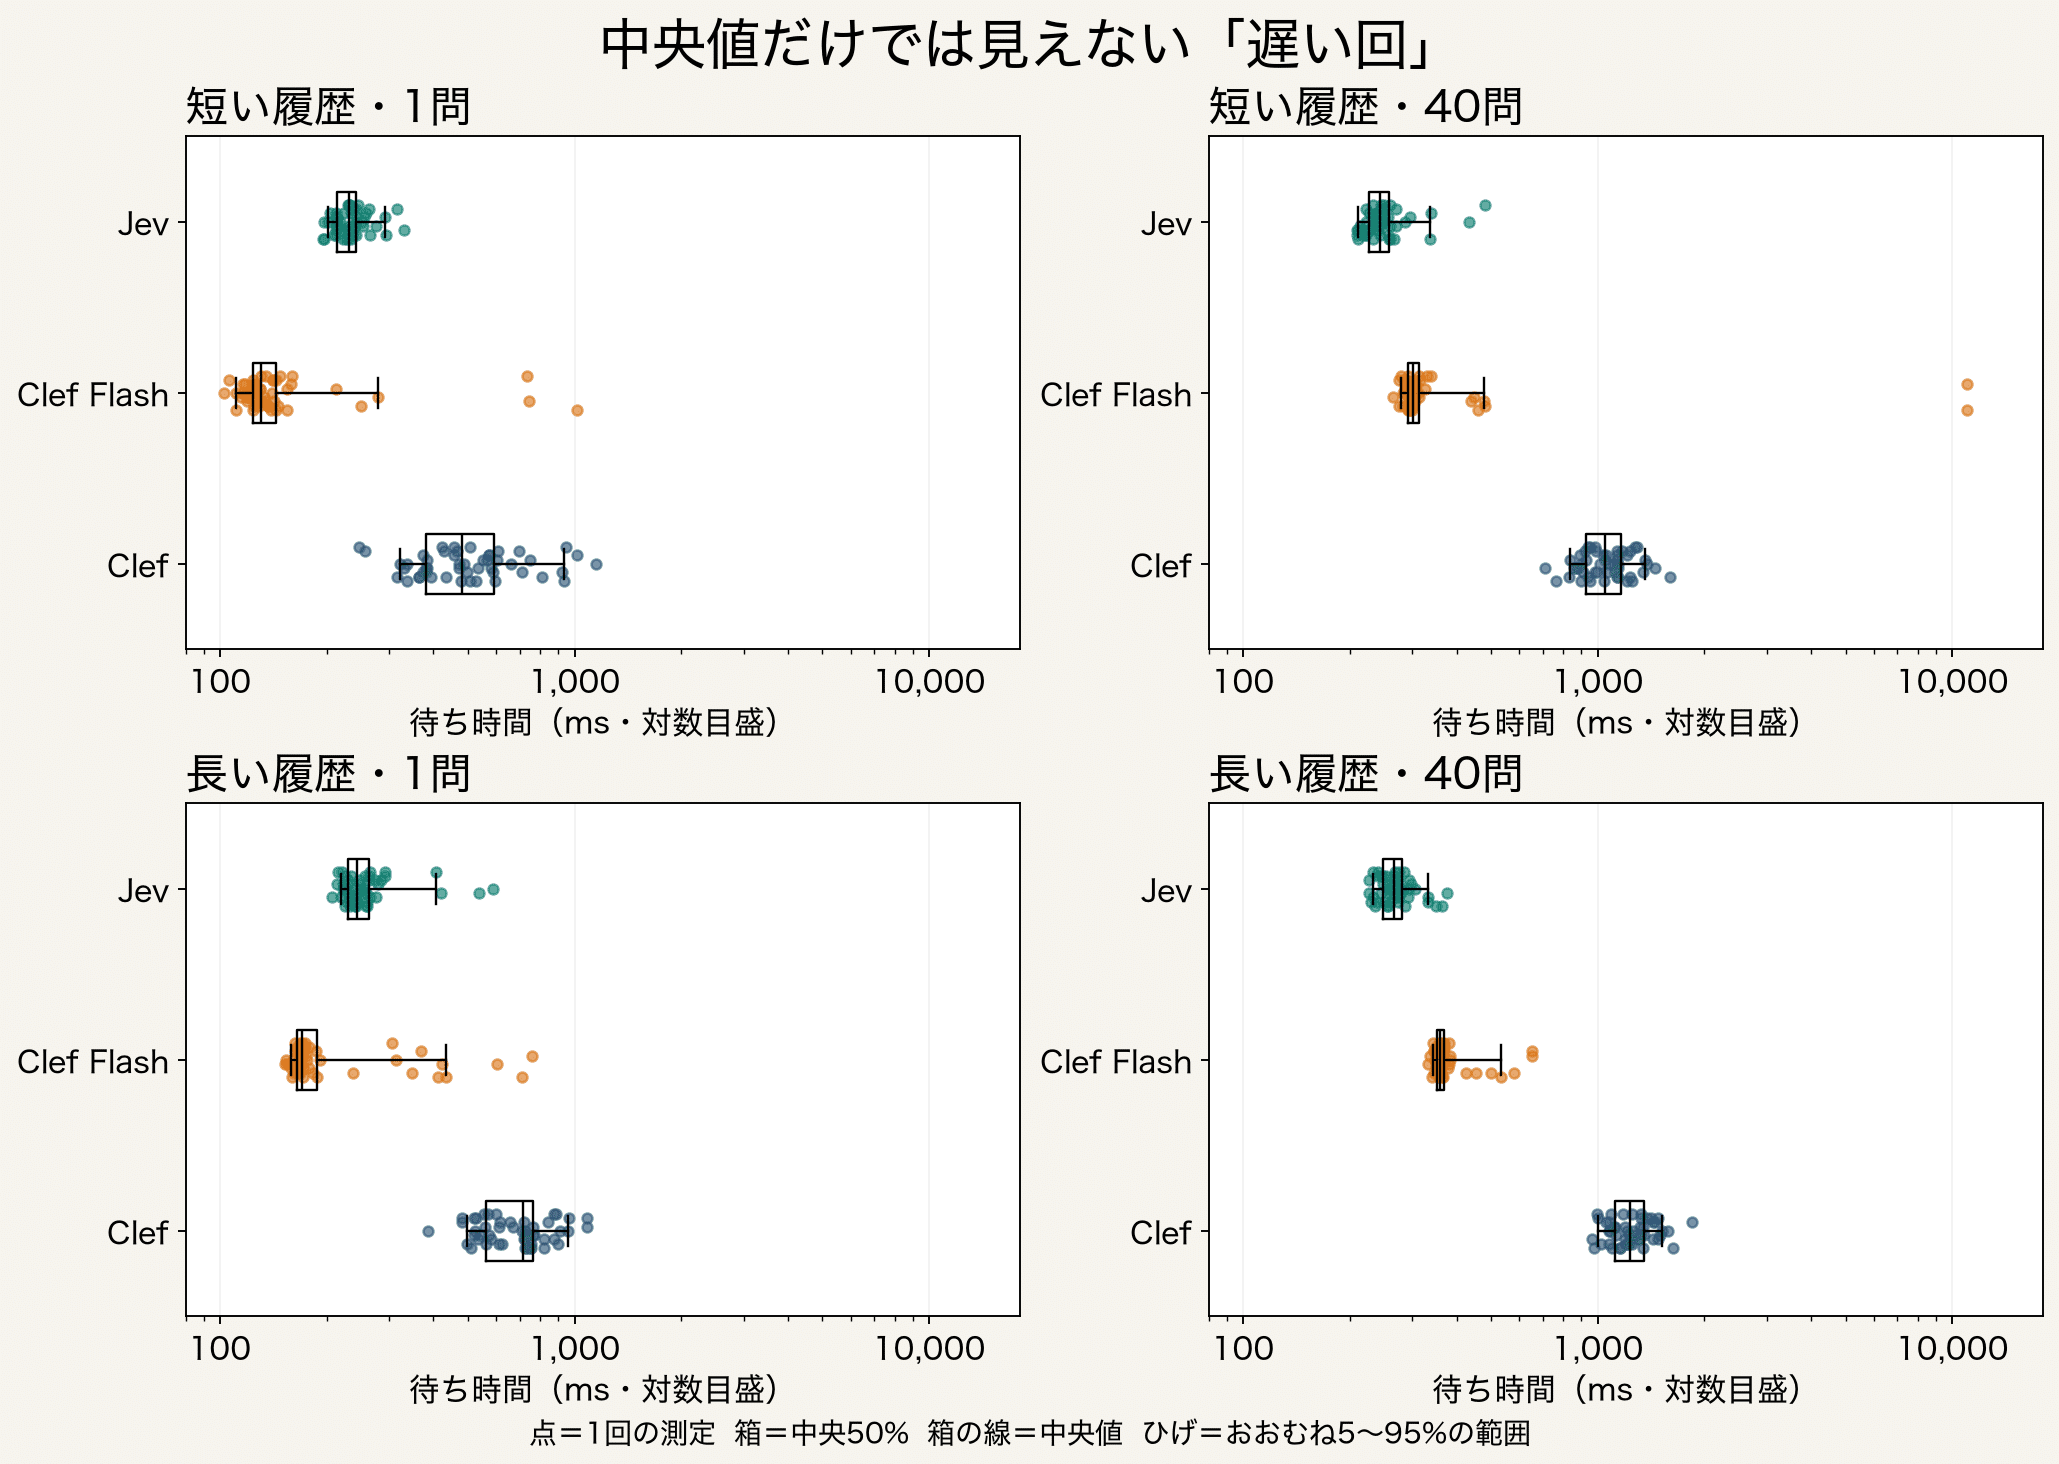
図2の右上に位置するClef Flash(橙色)を見ると、大半のデータは300ms前後に集中しているものの、右端に約11秒のプロットが2点確認できます。つまり、「通常時は高速だが、稀に極端な遅延が発生する」という分布傾向を示しています。
この条件におけるClef Flashの統計値は、中央値301msに対し、平均値は743ms、標準偏差は2,118msに達しました(標本分散は約4,485,378ms²)。一方、同条件のJevは平均253ms、標準偏差50ms(標本分散は約2,523ms²)と、今回の測定では待ち時間のばらつきが小さくなりました。実際のユーザー体験やシステムの安定稼働を評価する上では、レイテンシのばらつきの小ささを示す標準偏差が重要な指標となります。
平均は総待ち時間を回数で割った値です。標準偏差は待ち時間のばらつきの大きさを表し、値が大きいほど毎回の待ち時間が揃っていません。分散は標準偏差を2乗したものです。利用者の体感を考えるときは、msの単位で読める標準偏差の方がイメージしやすいと思います。
さらに、この条件におけるClef Flashの95パーセンタイル値(p95:50回中48番目に速い値)は482msでした。約11秒を記録した2回は49番目・50番目にあたるため、p95の数値には現れません。中央値やp95だけでなく、最大値や分布全体を把握することの重要性がここにあります。
テキスト検証の計600回において、Clefにはこのような極端な遅延は見られず、最大でも約1.84秒でした(Jevの最大値は約0.59秒)。ただし、これをもって「Clefでは長時間の遅延が起きない」と結論づけることはできません。後述する画像検証において、Clefでも同様のスパイクが発生しています。
遅延の原因としては、ネットワークの混雑、コンテナ等のコールドスタート(起動処理)、内部リトライ、基盤側の通信などが考えられますが、今回のログからは特定に至っていません。本番環境へ導入する際は、モデルの種類を問わず、適切なタイムアウト値の設定やリトライポリシーの設計が不可欠です。
6. コスト比較:料金はJevが最安。同じ入力でもトークン数は異なる
2026年10月2日時点で確認した、入力100万トークンあたりの公式単価は以下の通りです。
Jev:$0.042
Clef Flash:$0.09(Jevの約2.1倍)
Clef:$0.24(Jevの約5.7倍)
同じトークン数であれば上記のような価格差になりますが、実際には入力テキストが同一であっても、モデルごとのトークナイザーや内部フォーマットの違いにより、API側で消費されるトークン数は異なります。
今回の「長い履歴・40問」における実測値では、Jevが8,290入力トークンだったのに対し、Clefシリーズは5,720入力トークンでした。この実測トークン数をもとに1,000回あたりのコストを試算した結果が以下となります。
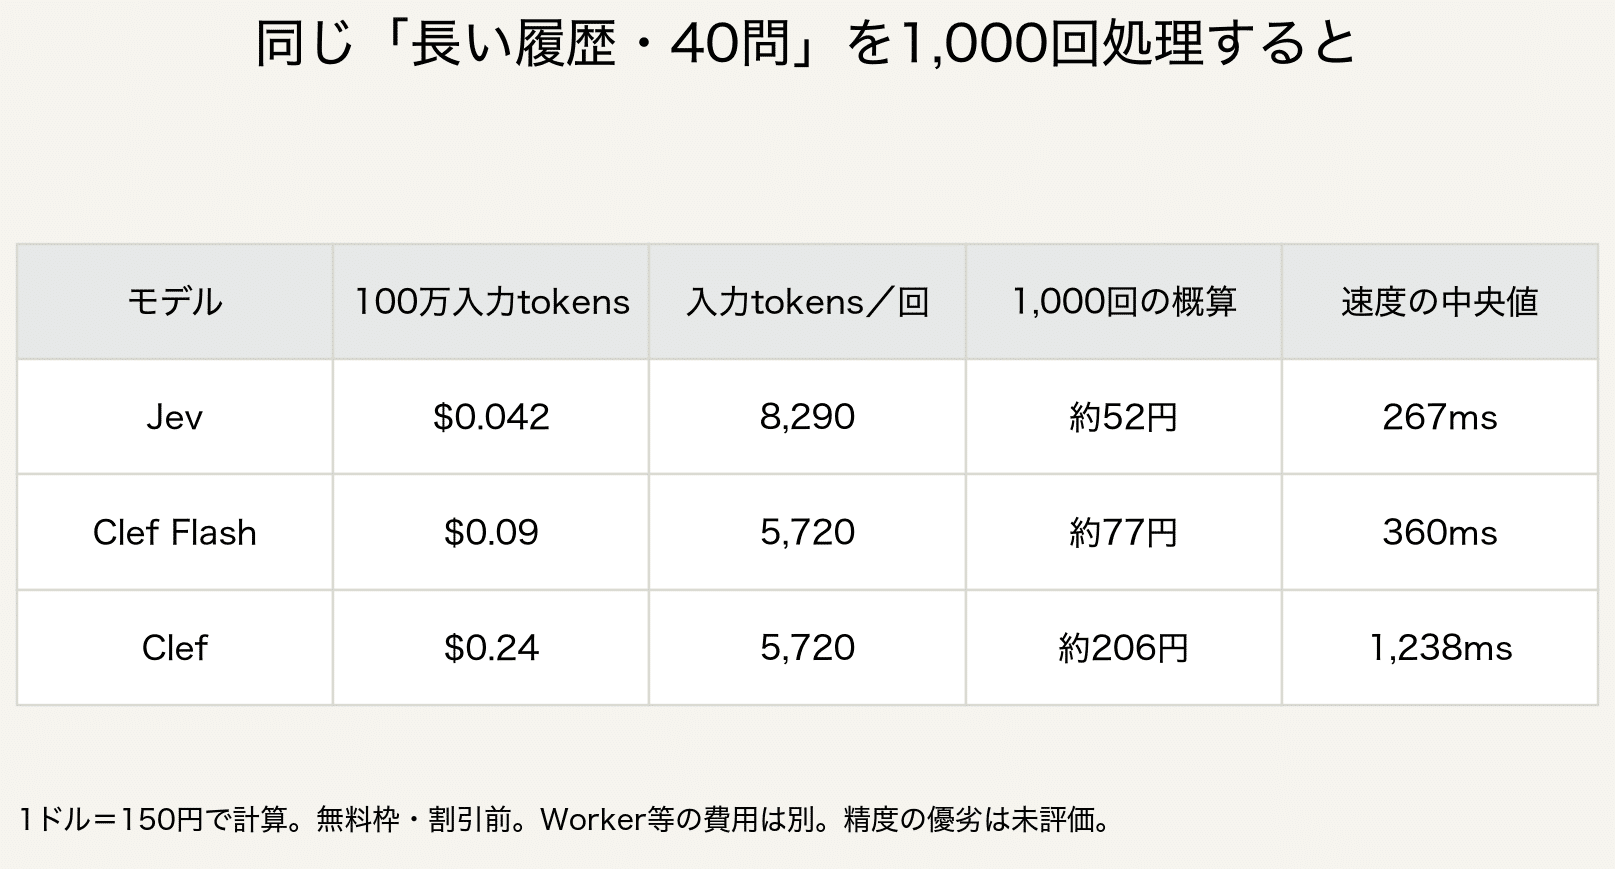
Jev:約52円
Clef Flash:約77円
Clef:約206円 (※1ドル=150円換算。無料枠や各種割引適用前の純粋なモデル利用料であり、Worker等の実行基盤コストは含みません)
1回あたりの差額はわずかですが、日次で数万〜数十万回規模のリクエストを処理するシステムでは、無視できないコスト差になります。この「40問一括」の条件下においては、Jevが処理速度・コストの両面で最も有利な結果となりました。ただし、これは両者の判定精度が同等であることを証明したものではない点に留意が必要です。
なお、前回の記事執筆時点では、Cloudflare経由のJevの料金はダッシュボード上での確認が必要でしたが、現在は公式モデルページ上にも「入力$0.042/100万トークン、出力無料」と明記されています。
7. Clefシリーズの独自価値:マルチモーダル対応(画像判定)の実証
続いて、テキスト特化型のJevでは対応できない「画像入力」の検証を行いました。ClefおよびClef Flashはマルチモーダル入力に対応しているため、UIのスクリーンショット検証や画像の自動分類といったユースケースへの適用が期待されます。
今回は画像入力に伴う課金体系と挙動を確認するため、赤い円と青い四角形を配置したシンプルなテスト画像を生成しました。
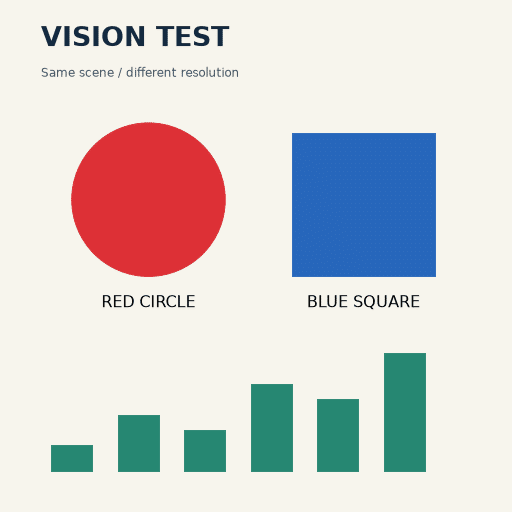
検証では、「赤い円が描かれていますか?」「青い四角形が描かれていますか?」という2つの日本語の質問を用い、「画像なし」をベースラインとして各解像度・各モデルで3回ずつ計測を行いました(各条件でウォームアップを1回ずつ事前に実施)。 なお、公式APIの画像入力仕様はPNG・JPEG・WebP形式に対応し、最大4枚まで送信可能です。今回の検証では正方形のPNG画像1枚を使用しています。
画像入力に伴うトークン消費量とコスト
「画像なし」の場合の入力トークン数は253トークンでした。これに対し、画像を追加すると解像度に応じて以下のようにトークン数が増加しました。
256px四方:320トークン
512px四方:512トークン
1024px四方:1,280トークン
2048px四方:1,280トークン
3072px四方:1,280トークン
注目すべきは、1024px四方以上では解像度を上げてもトークン数が1,280トークンで頭打ちとなった点です。両モデルとも、該当条件の全試行で一貫して同一のトークン数を返却しました。
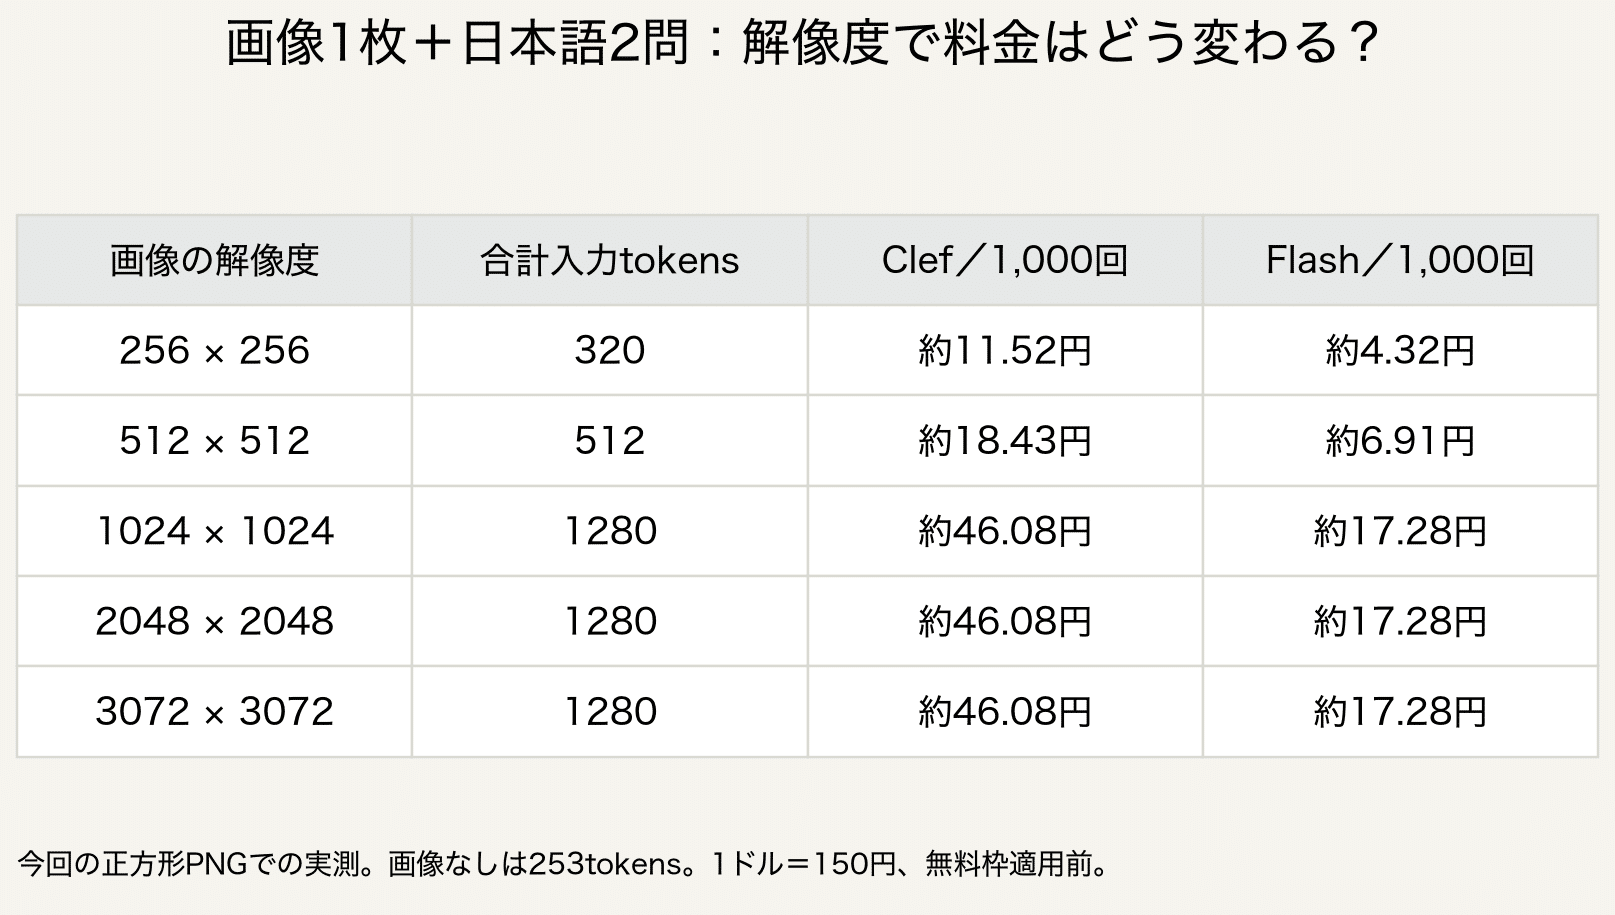
1024px四方の画像1枚と日本語2問の組み合わせにおける試算では、Clef Flashが1回あたり約0.017円(1,000回で約17円)、Clefが1回あたり約0.046円(1,000回で約46円)となります。
1024px以上でトークン消費量が増加しない要因としては、モデル内部での自動リサイズ処理や入力トークン数の上限仕様などが推測されます。ただし、APIの返却値から内部の処理仕様を断定することはできません。アスペクト比が異なる場合や複数枚送信する場合にも同一の挙動になるとは限らないため、汎用的な換算式として一般化することは避けるべきです。
画像入力時の処理速度
画像を入力した場合においても、本測定3回の中央値ベースでは、すべての解像度でClef Flashの方が高速でした(例:1024px四方ではClef Flashが447ms、Clefが697ms)。
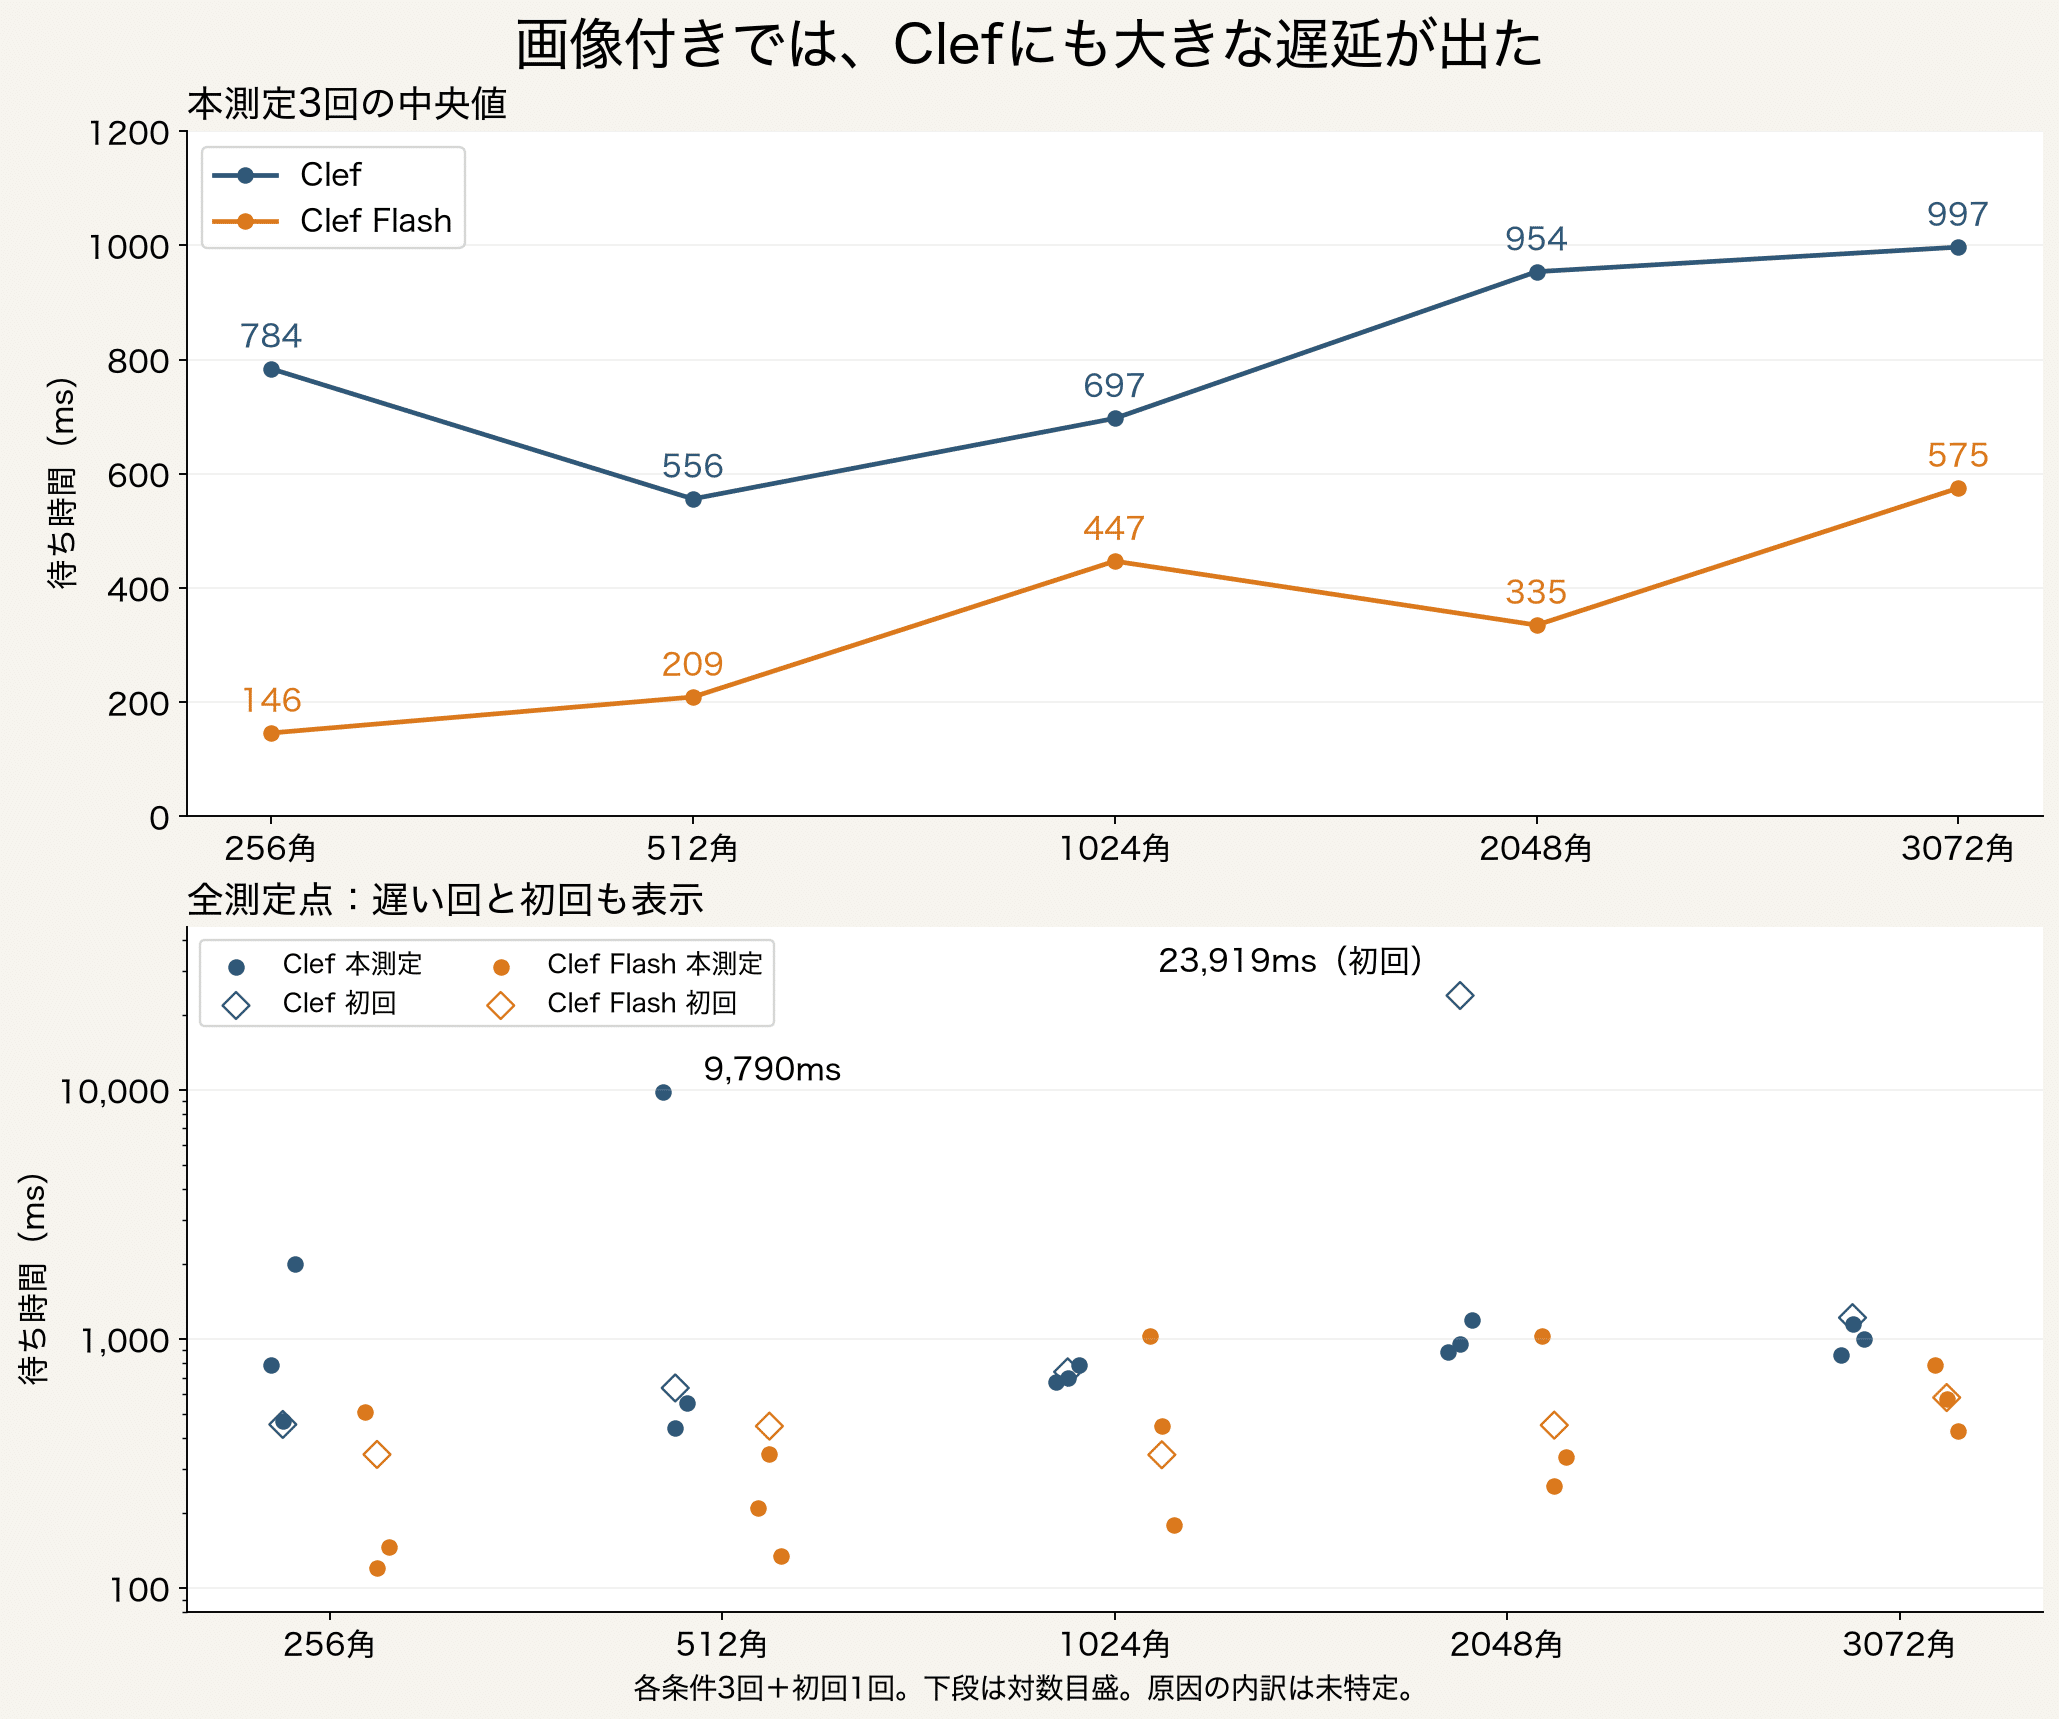
ただし、この画像検証においてはClef側にも著しいレイテンシスパイクが確認されました。512px四方の本測定で9.79秒、2048px四方のウォームアップでは23.92秒を記録しています。
テキスト検証の結果だけを見ると、Clefは速度面でFlashに劣るものの比較的安定しているように見えましたが、条件を変えることでこうした大幅な遅延が発生し得ることがわかります。したがって、今回の測定結果はあくまで特定の条件下における振る舞いとして解釈する必要があります。
また、画像に関する測定回数は各条件3回と限られているため、解像度ごとの細かな速度差は参考値にとどまります。高解像度画像ではペイロードの転送や前処理の負荷も影響し得ますが、今回の検証ではその内訳までの分解は行っていません。
判定精度の解釈に関する注意点
今回の2つの質問に対し、出力された確率値が50%以上を「該当あり」と判定した場合、両モデルとも本測定の全30判定で正答率100%となりました(Clefは約99%、Clef Flashは約97〜98%の確率値を返却)。
しかし、これは「5つの解像度 × 2問 × 3回」の試行結果であり、30種類の異なる画像を評価したわけではありません。極めて単純な同一画像の繰り返し評価に過ぎず、画像内に「RED CIRCLE」などのテキストラベルが含まれていたため、文字情報が手がかりとなった可能性もあります。正解はすべて「ある」で、対象が存在しない例は含めていません。
したがって、「今回の単純画像は双方とも正しく認識できた」とは言えるものの、「両モデルの画像認識精度が同等である」あるいは「Clefの方が高精度である」と結論づけるのは早計です。文字情報を含まない実写写真、微小な対象物、対象物が存在しないネガティブケースなどを用いた網羅的な検証が別途必要です。また、返却される確率値が高いことが、そのまま実務上の正答率の高さを保証するわけではない点にも注意が必要です。
8. Cloudflare Workersからの実装例
Workers AIのAIバインディングを設定済みの環境であれば、基本実装は以下のようになります。
const response = await env.AI.run('@cf/cloudflare/clef-flash', {
  model: 'clef-flash',
  state: '添付画像の画面状態を確認してください。',
  images: [imageDataUrl], // data:image/png;base64,... 形式
  questions: {
    has_error: {
      type: 'noul',
      instructions: '画面にエラーメッセージが表示されていますか?'
    }
  }
});
const probability = response.answers.has_error.noul;
Clefを利用する場合は、呼び出し先モデルを@cf/cloudflare/clefとし、パラメータ内のmodel指定をclefに変更します。テキストのみの判定を行う場合は、imagesパラメータを省略します。
画像データは、上記のようなData URL形式、またはcontent_typeとbase64プロパティを持つオブジェクトとして渡す必要があります。一般的なWeb上の画像URLを直接渡す形式ではない点にご注意ください。詳細なサイズ制限や入力スキーマについては公式ドキュメントを参照してください。
9. まとめ:用途に応じたモデル選定の指針
以上の検証結果を踏まえ、実務における選定指針を以下のように整理しました。
日本語テキストに対し、1問のみを高速に判定したい場合
Clef Flash が第一候補となります。単発のリクエスト処理において、最も短いレイテンシ(中央値)を記録しました。大量のテキスト判定や、複数質問の一括バッチ処理を行いたい場合
引き続き Jev が極めて有力な選択肢です。多数の質問をまとめた処理において、今回の40問の条件では、処理速度・コストの両面で有利な結果でした。画像を含むマルチモーダル判定を行いたい場合
Clefシリーズ を候補として試します。まずはコストと速度に優れるClef Flashを軸に検討し、判定難易度が高い画像やミッションクリティカルな業務要件では、アノテーション済みデータを用いてClefとの精度比較を行った上で選定することを推奨します。Clefへの追加コスト・遅延許容の判断基準
今回の速度・コスト検証のみで判断するのではなく、対象ユースケースにおいてClefがどれほど精度面でのアドバンテージを発揮できるかを実測・検証した上で決定すべきです。
新モデルが登場すると「既存モデルの完全上位互換か」という観点で評価されがちですが、今回の検証が示す通り、判定対象のデータ形式やリクエストの集約方法によって最適なモデルは異なります。
大量のテキスト判定を低コストで行う用途では、Jevが引き続き有力な選択肢です。一方でClefシリーズは、画像を判断材料に組み込める柔軟性や、Cloudflare Workers環境との高い親和性、モデルの重みが公開されているオープン性を備えています。
「判定特化型AI」の選択肢が広がったことで、単なる処理速度だけでなく、入力データの種類や運用設計に応じた最適なアーキテクチャの選択が可能になりました。AGIラボでは今後も、実際の業務データやUI画面を用いた精度検証を通じて、より実践的な使い分けを深掘りしていく予定です。
測定メモ・参考リンク
測定実施日:2026年10月2日。AGI Cockpitからスクリプトを実行し、Wranglerの一時的なリモートプレビュー環境上で計測。東京リージョン(NRT)の同一Workerから呼び出しを行い、AI Gatewayのキャッシュは明示的にバイパスしています(プロバイダー内部でのプレフィックス再利用等までは制御・検証していません)。
測定サンプル数:
テキスト検証:4条件 × 3モデル × 50回 = 計600回(別途ウォームアップ24回)。同一の固定合成データを繰り返し送信した測定であり、異なる600件の文章を評価したものではありません。
画像検証:(画像なし + 5解像度)× 2モデルについて本測定36回(別途ウォームアップ12回)。
AGIラボの実測部分における処理速度と料金の試算は、上記のデータに基づきます。第2節の公式ベンチマークはCloudflare公表の別のデータです。
統計処理および免責事項:
分散は不偏分散(分母n−1の標本分散)、p95は昇順ソートにおける48番目の値を採用。成功レスポンスの外れ値除外は行っていません。
分布図のボックスプロットは可視化ライブラリの分位点算出処理に準拠しており、ヒゲの両端と本文中のp95値では丸め処理や補間アルゴリズムの定義が異なる場合があります。
なお、モデルの判定精度、同時リクエストの負荷耐性、日時によるパフォーマンス変動、推論GPUの物理的所在地は今回の検証範囲外となります。
参考リンク