AGIラボではこれまで、判定特化型AIである「Jev」やCloudflareの「Clef / Clef Flash」を取り上げてきました。これらは、メールの自動振り分けや対応優先度の判断、AIエージェントの会話履歴の整理など、長文の生成を必要とせず、「どう判断すべきか」という結果だけを素早く得たい業務で効果を発揮するAIです。
今回、その新たな選択肢としてOpenAIから「Decisions API」が登場しました。テキストだけでなく画像入力にも対応しており、判定結果を確率値や選択肢、スコアなどの形式で受け取れるAPIです。
では、日本語環境における応答速度はどの程度なのでしょうか。また、JevやClefと比較したコスト面はどうなのか。AGIラボでは、前回検証と同じ日本語プロンプトを用いて200回の速度測定を実施し、画像入力についても5段階の解像度で挙動を検証しました。
テキスト処理における応答速度の中央値は、約0.23〜0.32秒でした。1問のみを処理する条件ではJevに近く、40問をまとめて処理する条件ではClef Flashに近い水準となっています。
テキストによる計200回のリクエストにおいて、応答時間が3秒を超えたケースはゼロで、最も遅い回でも約1.16秒に収まりました。
画像入力については、解像度が高くなるにつれてコストが増加する結果となりました。1,024ピクセル四方以上でトークン数が頭打ちとなった前回のClefとは異なり、解像度を上げるにつれてトークン数が増え続ける挙動が確認されています。
本記事では、応答速度・コスト・画像入力の検証に加え、あらかじめ正解を用意したデータセットによる精度比較も実施しました。後半では、日本語100問および図形画像30種類を用いた比較結果を詳しくご紹介します。特定の合成データによる検証結果ではありますが、具体的な実測値を見ていきましょう。
関連記事:判定専用AI「JEV」の使い方・料金・実例 / Jevの競合:Cloudflare Clef / Clef Flashの実力を測る
1. Decisions APIとは?――OpenAIで「判定結果のみ」を高速取得
たとえば、受信した問い合わせメールから「緊急対応が必要かどうか」を判定する業務を考えてみます。通常の生成AIであれば、判断理由を説明する文章やJSON形式で出力させるのが一般的です。これに対してDecisions APIでは、判定結果を指定したデータ型(スキーマ)に沿って直接取得できます。
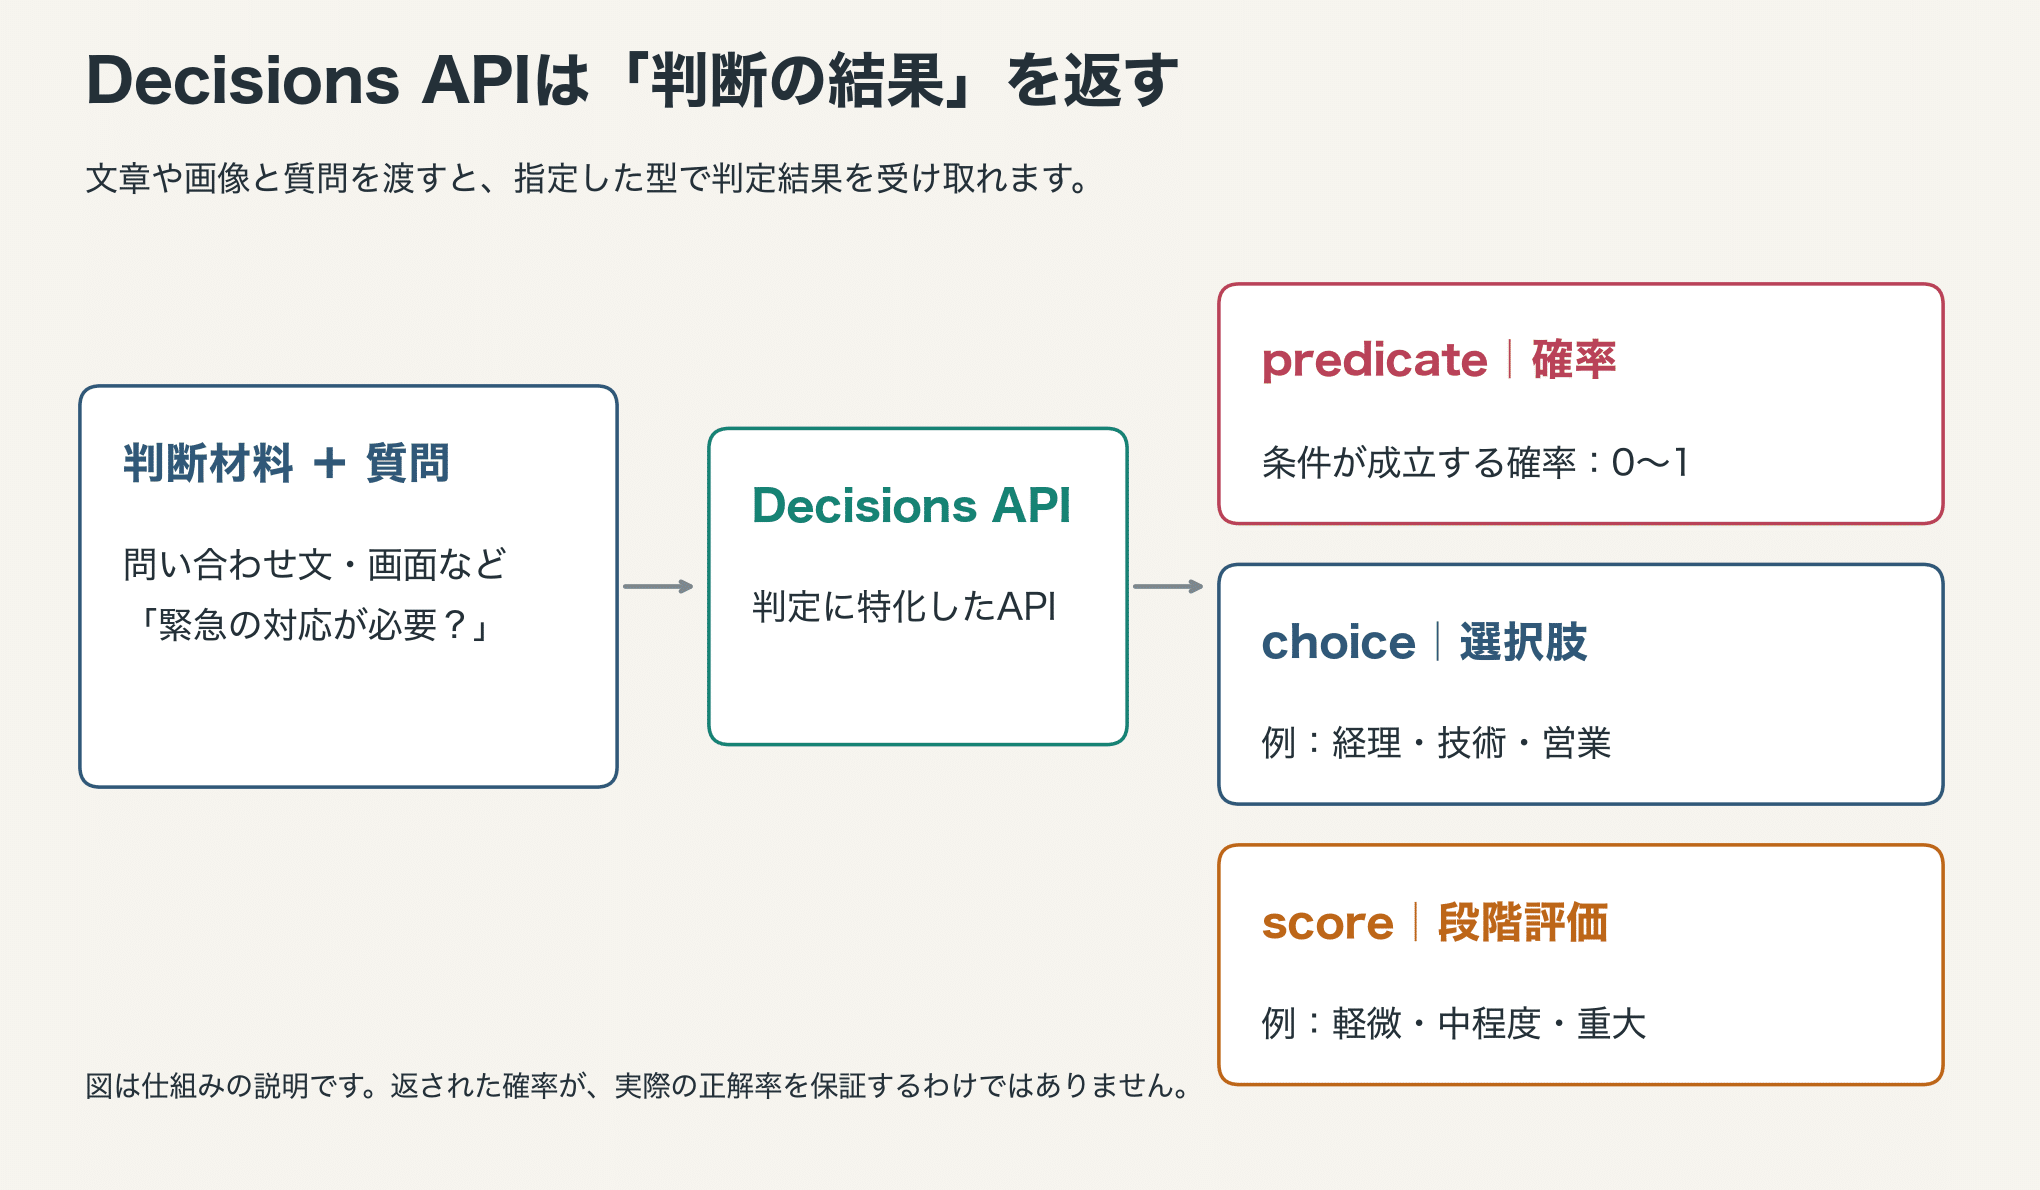
predicate:「緊急対応が必要か」などの条件に対し、成立する確率を0〜1の数値で返します。
choice:「経理・技術・営業のどこに振り分けるか」など、あらかじめ用意した選択肢の中から該当するものを返します。
score:「軽微・中程度・重大」など、順序性のある基準に基づいて段階的な評価値を返します。
JevやClefにおける「noul」に近い役割を、OpenAIでは「predicate」が担っています。基本的な設計思想は共通しているものの、APIのパラメータ名やレスポンスのデータ構造はサービスごとに異なる点に注意が必要です。
2026年10月7日に確認した公式ガイドではパブリックベータとして案内されており、対応モデルはgpt-6-luna。専用の POST /v1/decisions を使います。ブラウザで試せるPlaygroundも用意されています。
OpenAIは、本APIを利用することで従来のResponses APIよりも大幅に高速な判定が可能になるとしています。次節では、公式スライドで示された具体的な数値と比較条件を確認していきます。
2. OpenAI公式の速度比較:150ms vs 1.6秒
OpenAIがDevDay 2026で公開した比較データによると、タスク完了時間は従来のGPT-6 Luna APIが1.6秒(1,600ms)だったのに対し、Decisions APIはわずか150msでした。単純計算で約10.7倍の開きがあり、公式発表でも「約10倍高速」とアピールされています。
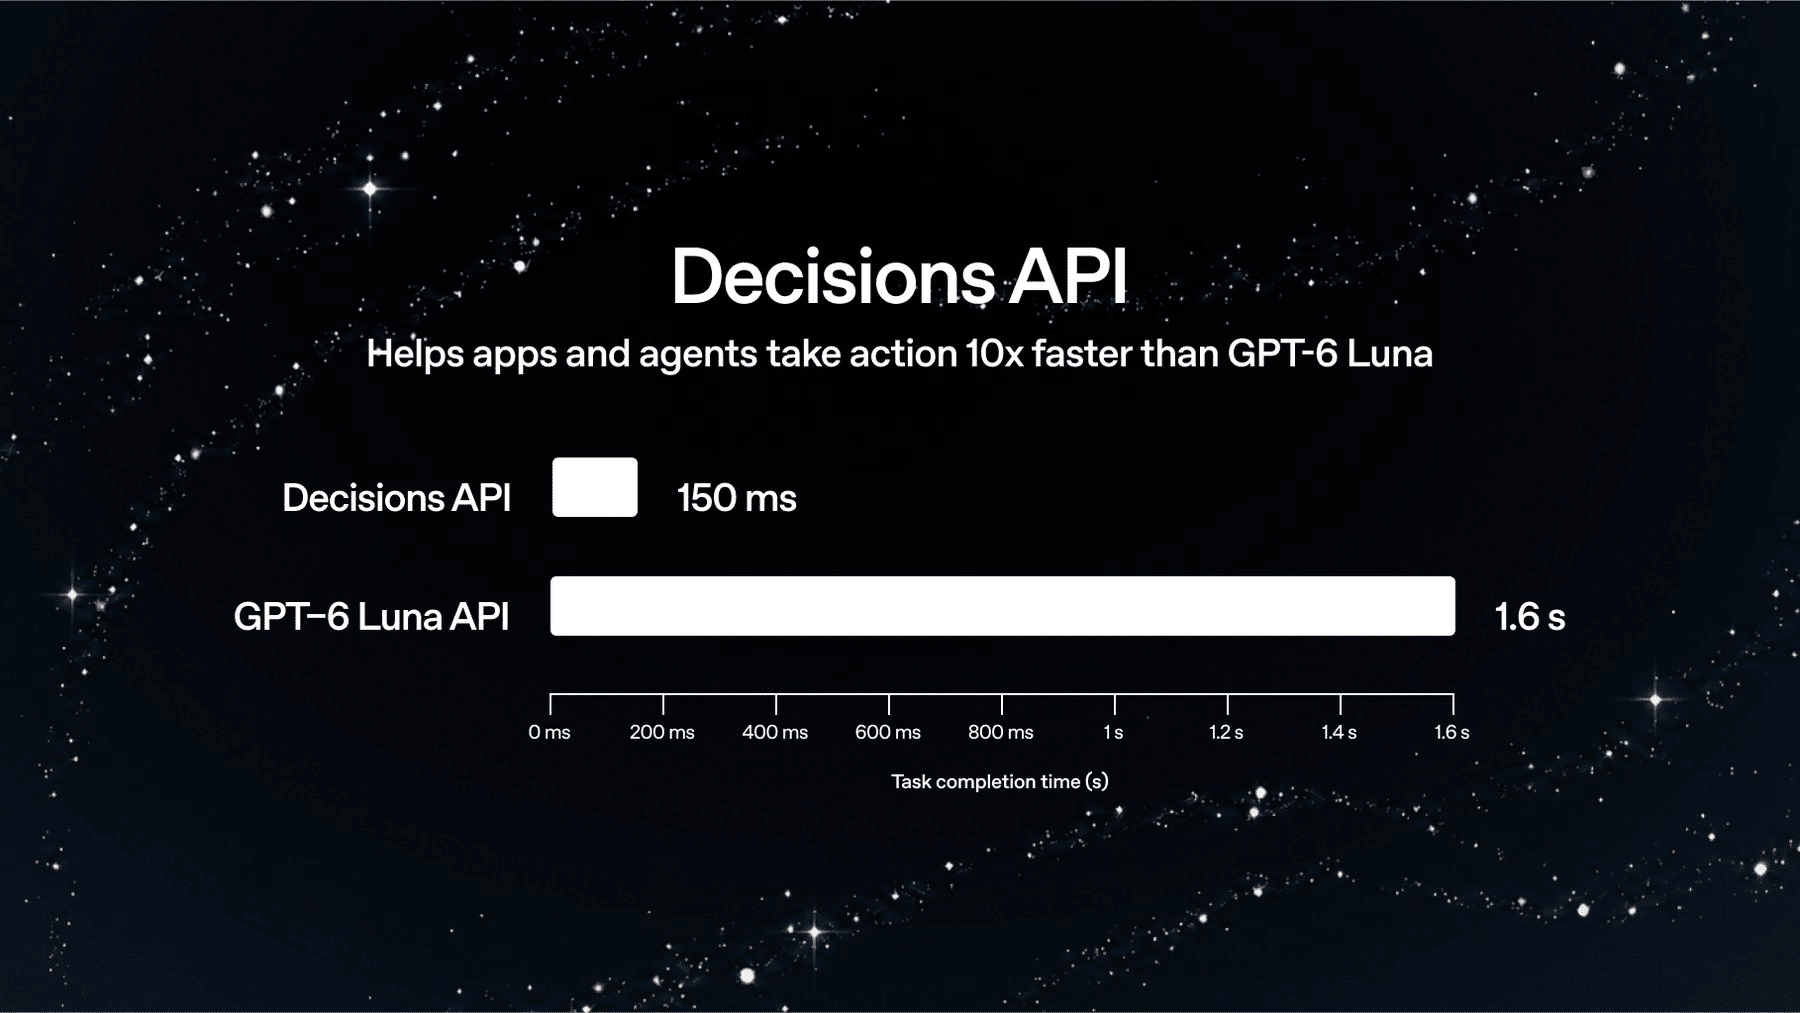
なお、ここでの比較対象はJevやClefではなく、OpenAI自身の「GPT-6 Luna API」です。10月6日付のベータ公開アナウンスでも、Responses API経由のGPT-6 Lunaと比較して「最大10倍高速」と説明されています。同じモデル系統をベースにしながらも、出力を選択や判定のみに絞り込むことで、待ち時間を短縮することを目指したAPIという位置づけです。
ただし、このグラフが示しているのはあくまで応答速度であり、正解率や画像認識の精度を比較したものではありません。また、提示された図や公式ガイド、公開アナウンスからは、プロンプトの入力長、質問数、試行回数、リクエスト元のリージョン、キャッシュの有無、集計基準(中央値か平均値か)といった測定条件の詳細までは確認できませんでした。そのため、150msという数値を「あらゆるリクエストで保証される値」とそのまま受け取るべきではない点には留意が必要です。
後述するAGIラボの実測(日本国内のNRT拠点からの検証)では、Decisions APIの応答時間の中央値は231.5〜322msとなりました。公式発表の150msよりは長いものの、入力データや測定環境が異なるため、この差だけで公式発表の数値を否定することはできません。一方で、差分のすべてが日本からのネットワーク遅延によるものとも断定できません。また、今回の検証では通常のResponses APIを測定していないため、「約10倍高速」という発表値の再現性を検証したものではない点にもご留意ください。
公式発表から読み取れるのは、「通常の生成APIに判定を頼む場合より短時間で返すことを目指している」という特徴です。それでは、先行するJevやClefと比べてどのような立ち位置になるのか、次節の独自検証で見ていきましょう。
出典:OpenAI:DevDay 2026発表 / OpenAI:パブリックベータ公開告知 / 公式ガイド / 発表スライドの掲載元(THE DECODER、画像クレジット:OpenAI)
3. 前回と同一の日本語データを用い、4条件×各50回で測定
今回のテストでは、コーディングエージェントの作業ログを模した合成データを使用しました。ログの履歴件数は20件とし、「このツール呼び出しの履歴を残すべきか」「出力の全文を保持する必要があるか」といった判定を行わせています。これは、エージェントが長時間タスクを実行した際の履歴整理(コンテキスト圧縮)を想定したシチュエーションです。なお、実際のユーザーの会話ログは一切使用していません。
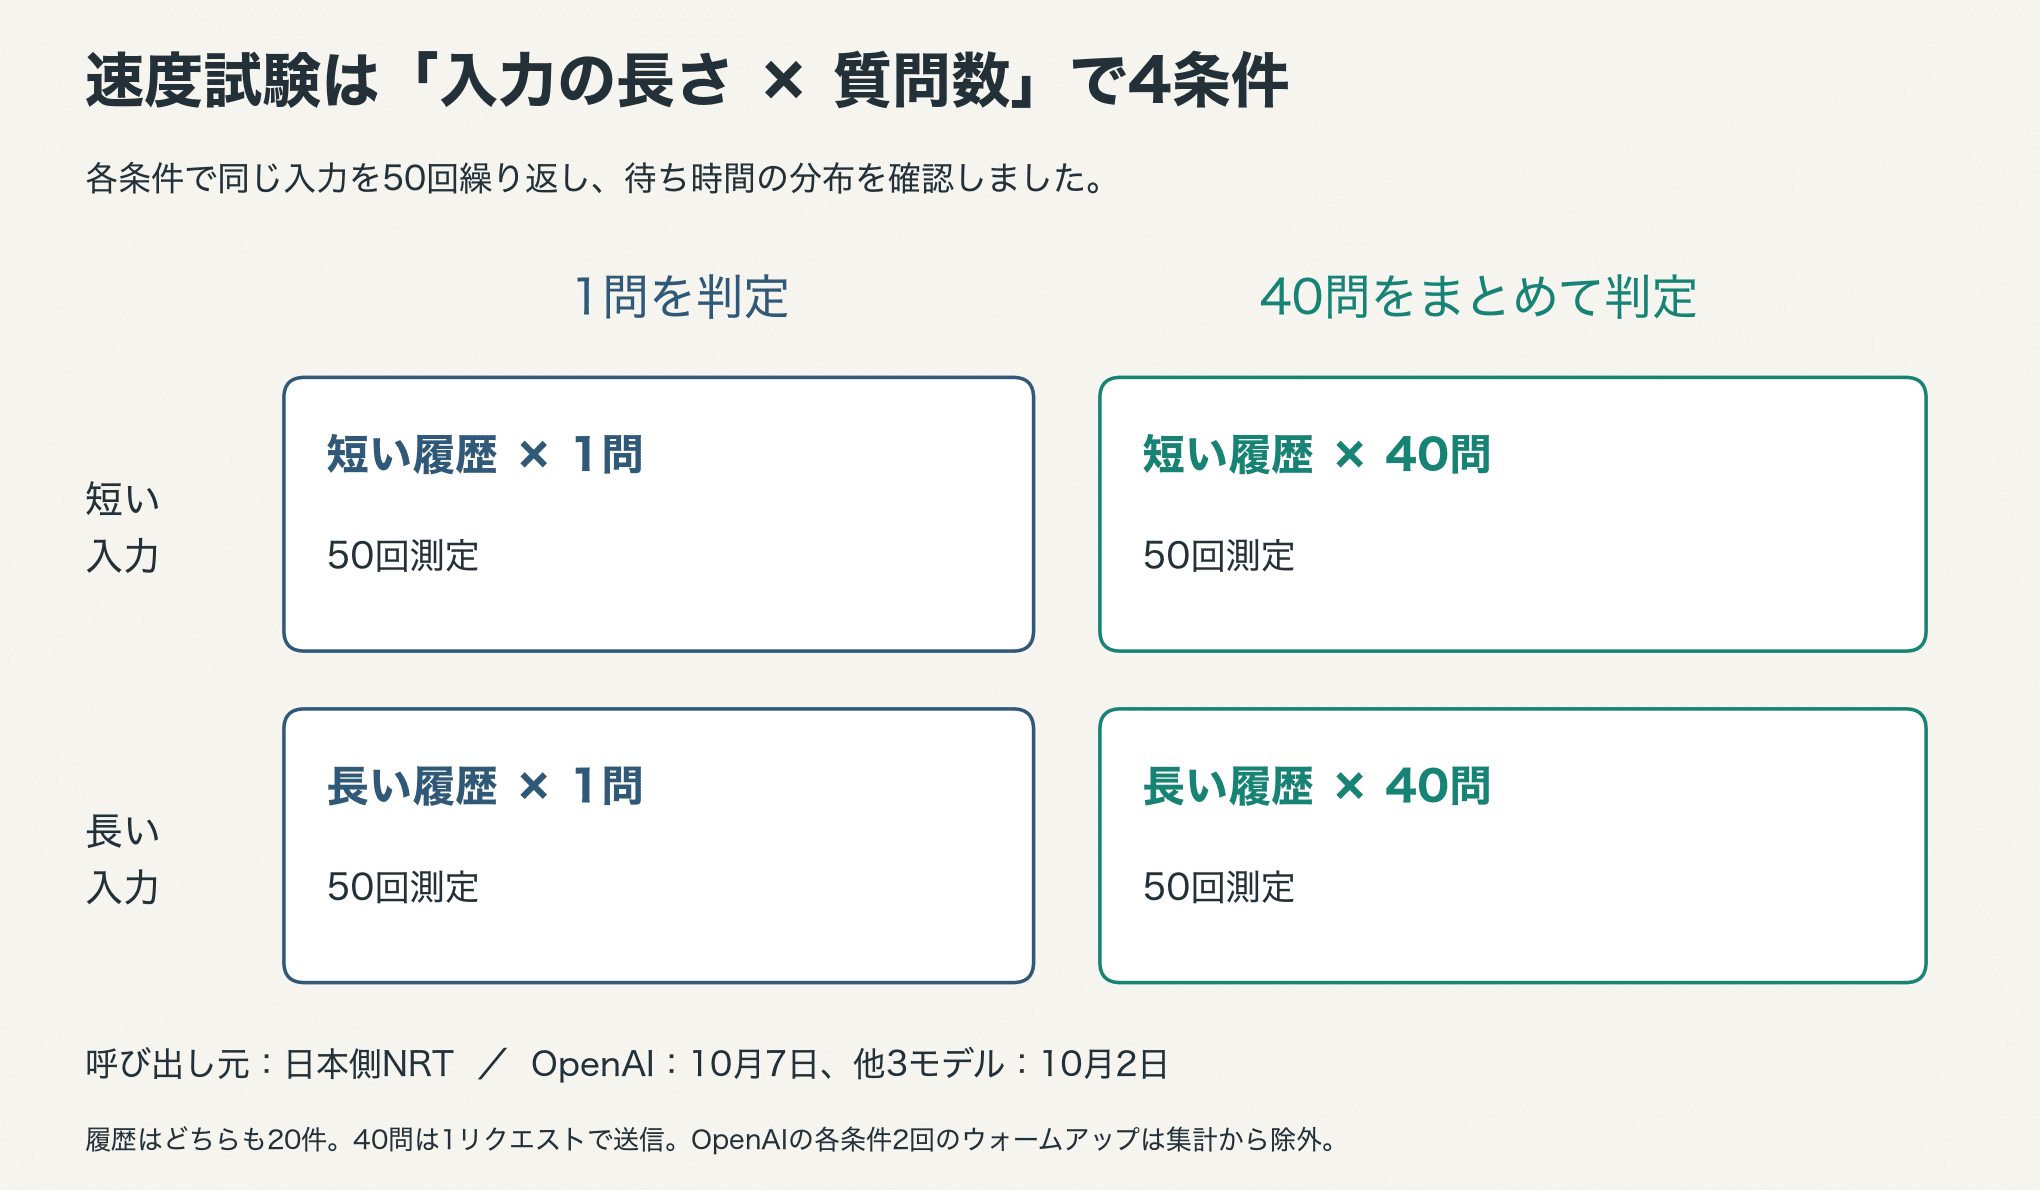
短い履歴 × 1問
短い履歴 × 40問
長い履歴 × 1問
長い履歴 × 40問
「短い履歴」と「長い履歴」の条件では、ログの件数(20件)は変えずに、含まれる出力テキストの長さを変えています。また、「40問」の条件は40回に分けて個別にリクエストするのではなく、1回のリクエストにまとめて一括送信しました。なお、「1問」の条件には、40問の中から抽出した同じ質問を採用しています。
Decisions APIには、前回検証で使用した判断材料をJSON文字列化したものを渡し、質問文もそのまま使用しました。変更したのは、各APIの仕様に合わせた入力スキーマと質問の型定義のみです。各条件で2回のウォームアップを実施した上で本測定を50回行い、合計200回のリクエストを計測しました。実行順序はラウンドごとに入れ替え、1回ずつ順に呼び出しています。なお、これは50種類の異なる文章を試したのではなく、同一の入力を用いて50回繰り返した測定結果です。
リクエストの送信元には、前回と同様に日本国内のCloudflareエッジ拠点「NRT(成田)」を使用しました。ただし、測定日時はOpenAIが10月7日、JevおよびClefが10月2日となっており、同時並行での測定ではない点にご留意ください。
所要時間は、Cloudflare Worker内でAPIを呼び出してからレスポンスを受信するまでの往復時間を計測しています。OpenAIは外部へのHTTPリクエストであるのに対し、前回の3モデルはCloudflare内部のWorkers AI(AI.run())を利用しているため、ネットワーク経路も異なります。したがって、純粋なGPUの計算処理時間だけでなく、通信や待機時間を含んだ「実運用上の待ち時間」を測定した結果となります。なお、クライアント端末からWorkerまでの通信時間は含まれていません。
4. 応答速度は約0.2〜0.3秒。40問の一括判定でも待ち時間は小さい
まずは中央値(メディアン)で比較します。中央値は、50回の測定値を昇順に並べた中央の値であり、「定常運用時の標準的な待ち時間」を把握する指標として適しています(1,000ms=1秒のため、250msは約0.25秒に相当します)。
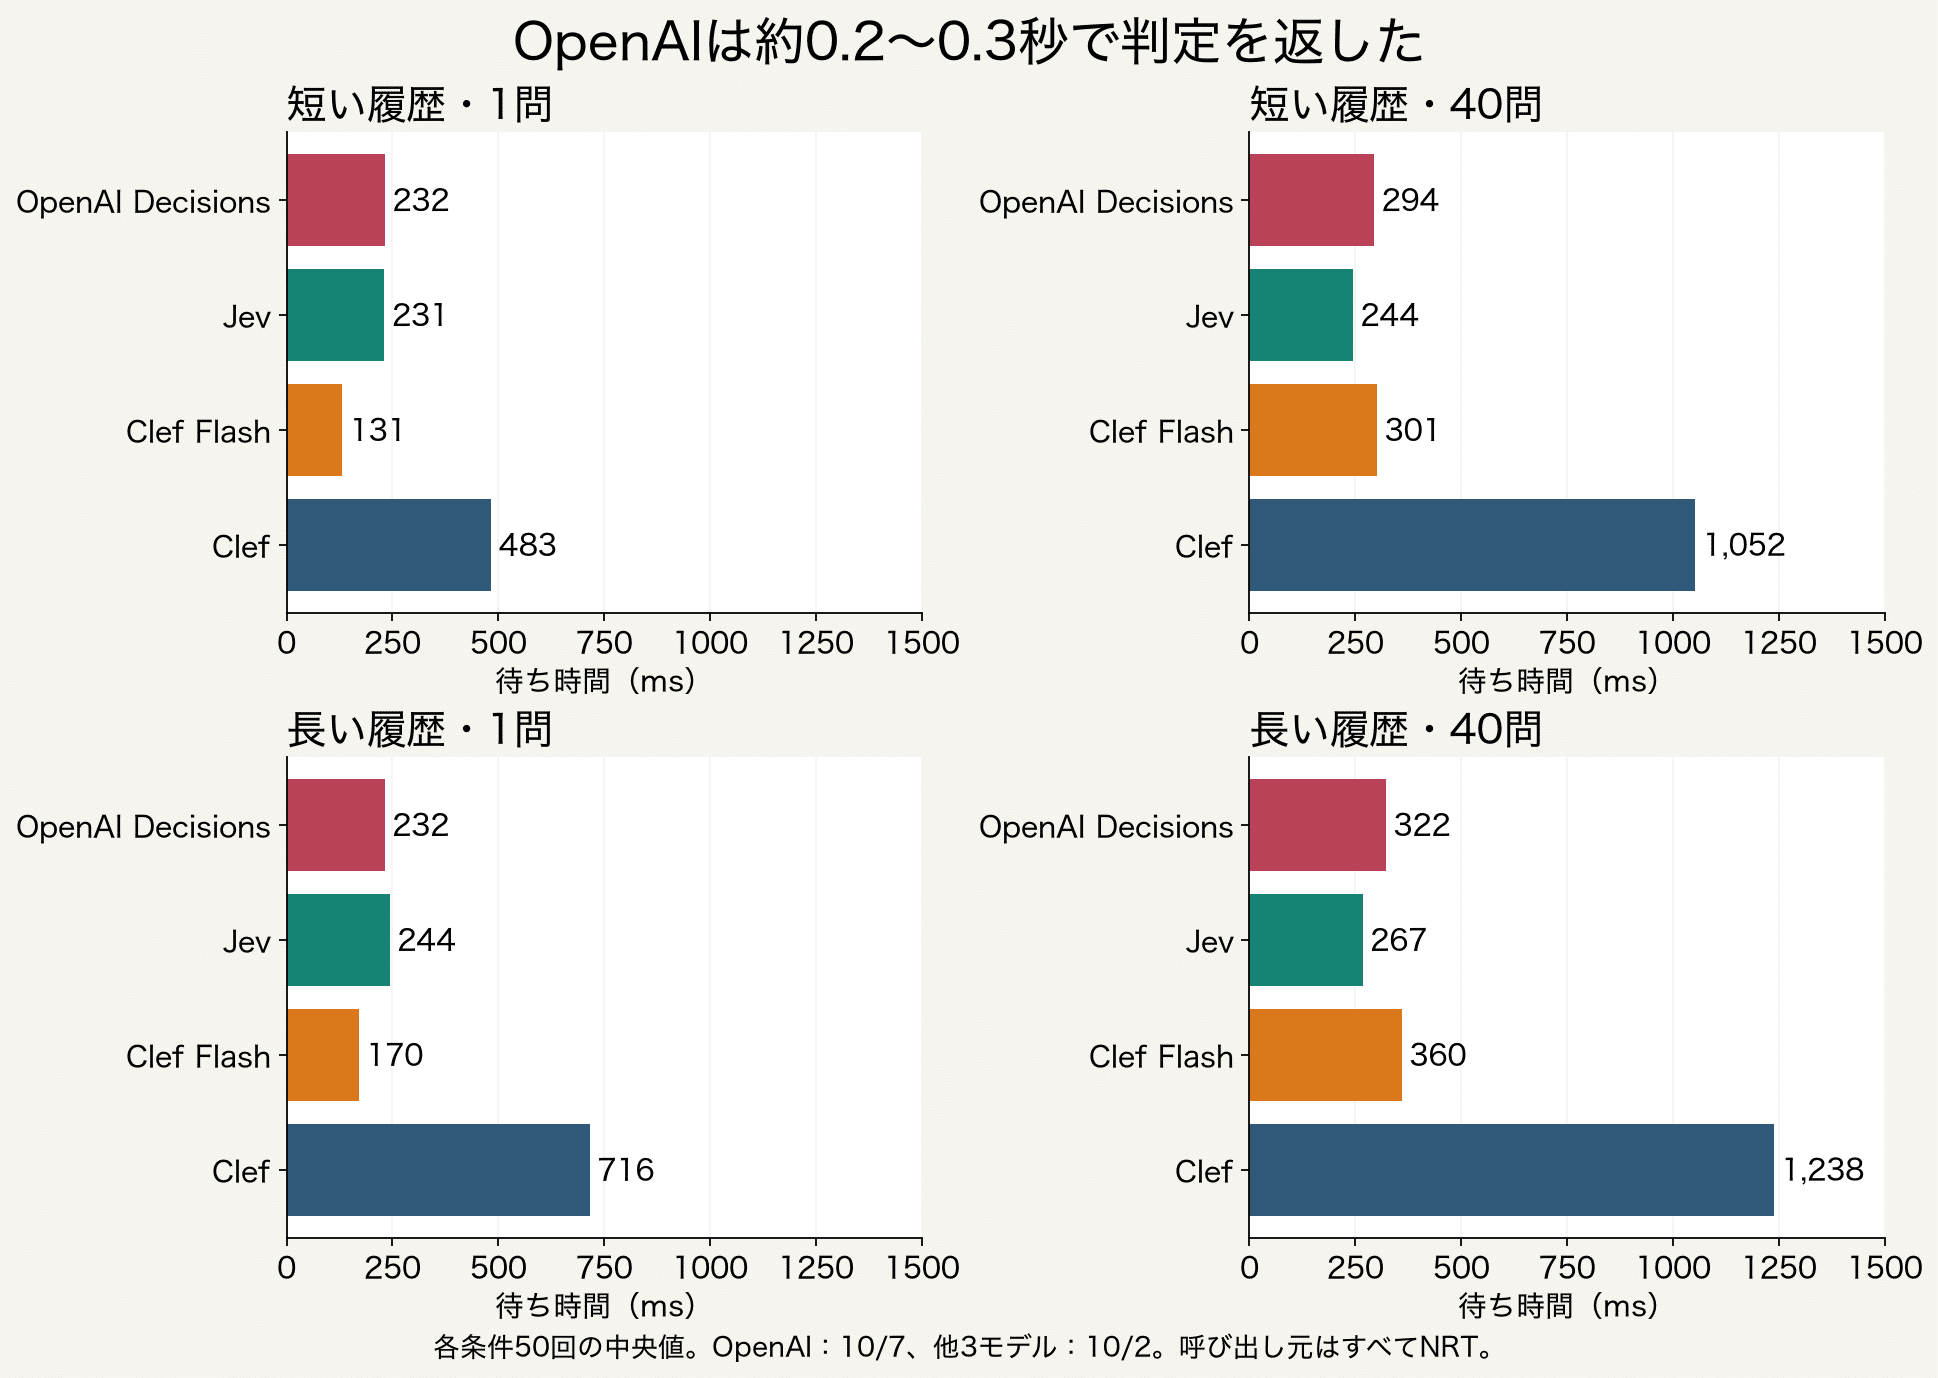
OpenAIのDecisions APIは、「短い履歴・1問」で232ms、「長い履歴・1問」でも231.5msと、今回の2条件では近い測定値になりました。前回のJevがそれぞれ231ms、243.5msだったため、1問のみの条件では近い水準でした。一方、Clef Flashは131msおよび170msを記録しており、今回比較したモデルの中では頭一つ抜けた速さを見せました。
質問数を40問に増やした場合、OpenAIは短い履歴で294ms、長い履歴で322msとなりました。1問の条件と比べた増加幅は約62〜91msにとどまっており、質問数が40倍になったからといって待ち時間が40倍に跳ね上がるわけではありません。
前回の検証における40問の条件では、Jevが244ms / 267ms、Clef Flashが301ms / 359.5ms、Clefが1,052ms / 1,237.5msという結果でした。これらと比べると、今回のOpenAIは「Jevよりはやや遅いものの、Clef Flashに極めて近く、Clefよりは大幅に高速」という位置づけになります。
ただし、「短い履歴・40問」におけるOpenAIとClef Flashの中央値の差はわずか7msです。測定日時やネットワーク経路の違いを考慮すると、このわずかな差をもって「OpenAIのほうが優位である」と結論づけることはできません。現時点では「ほぼ同等水準」と捉えるのが妥当です。
5. スパイク(極端な遅延)の有無:200回の試行で3秒超はゼロ
前回のClef Flashの検証では、「短い履歴・40問」の50回のうち2回で約11秒という大きな遅延が発生していました。通常は300ms程度で応答していても、ごく稀に発生する大幅な遅延が平均値を押し上げていたことになります。そこで今回のOpenAIについても、中央値だけでなく全測定データの分布を詳細に確認しました。
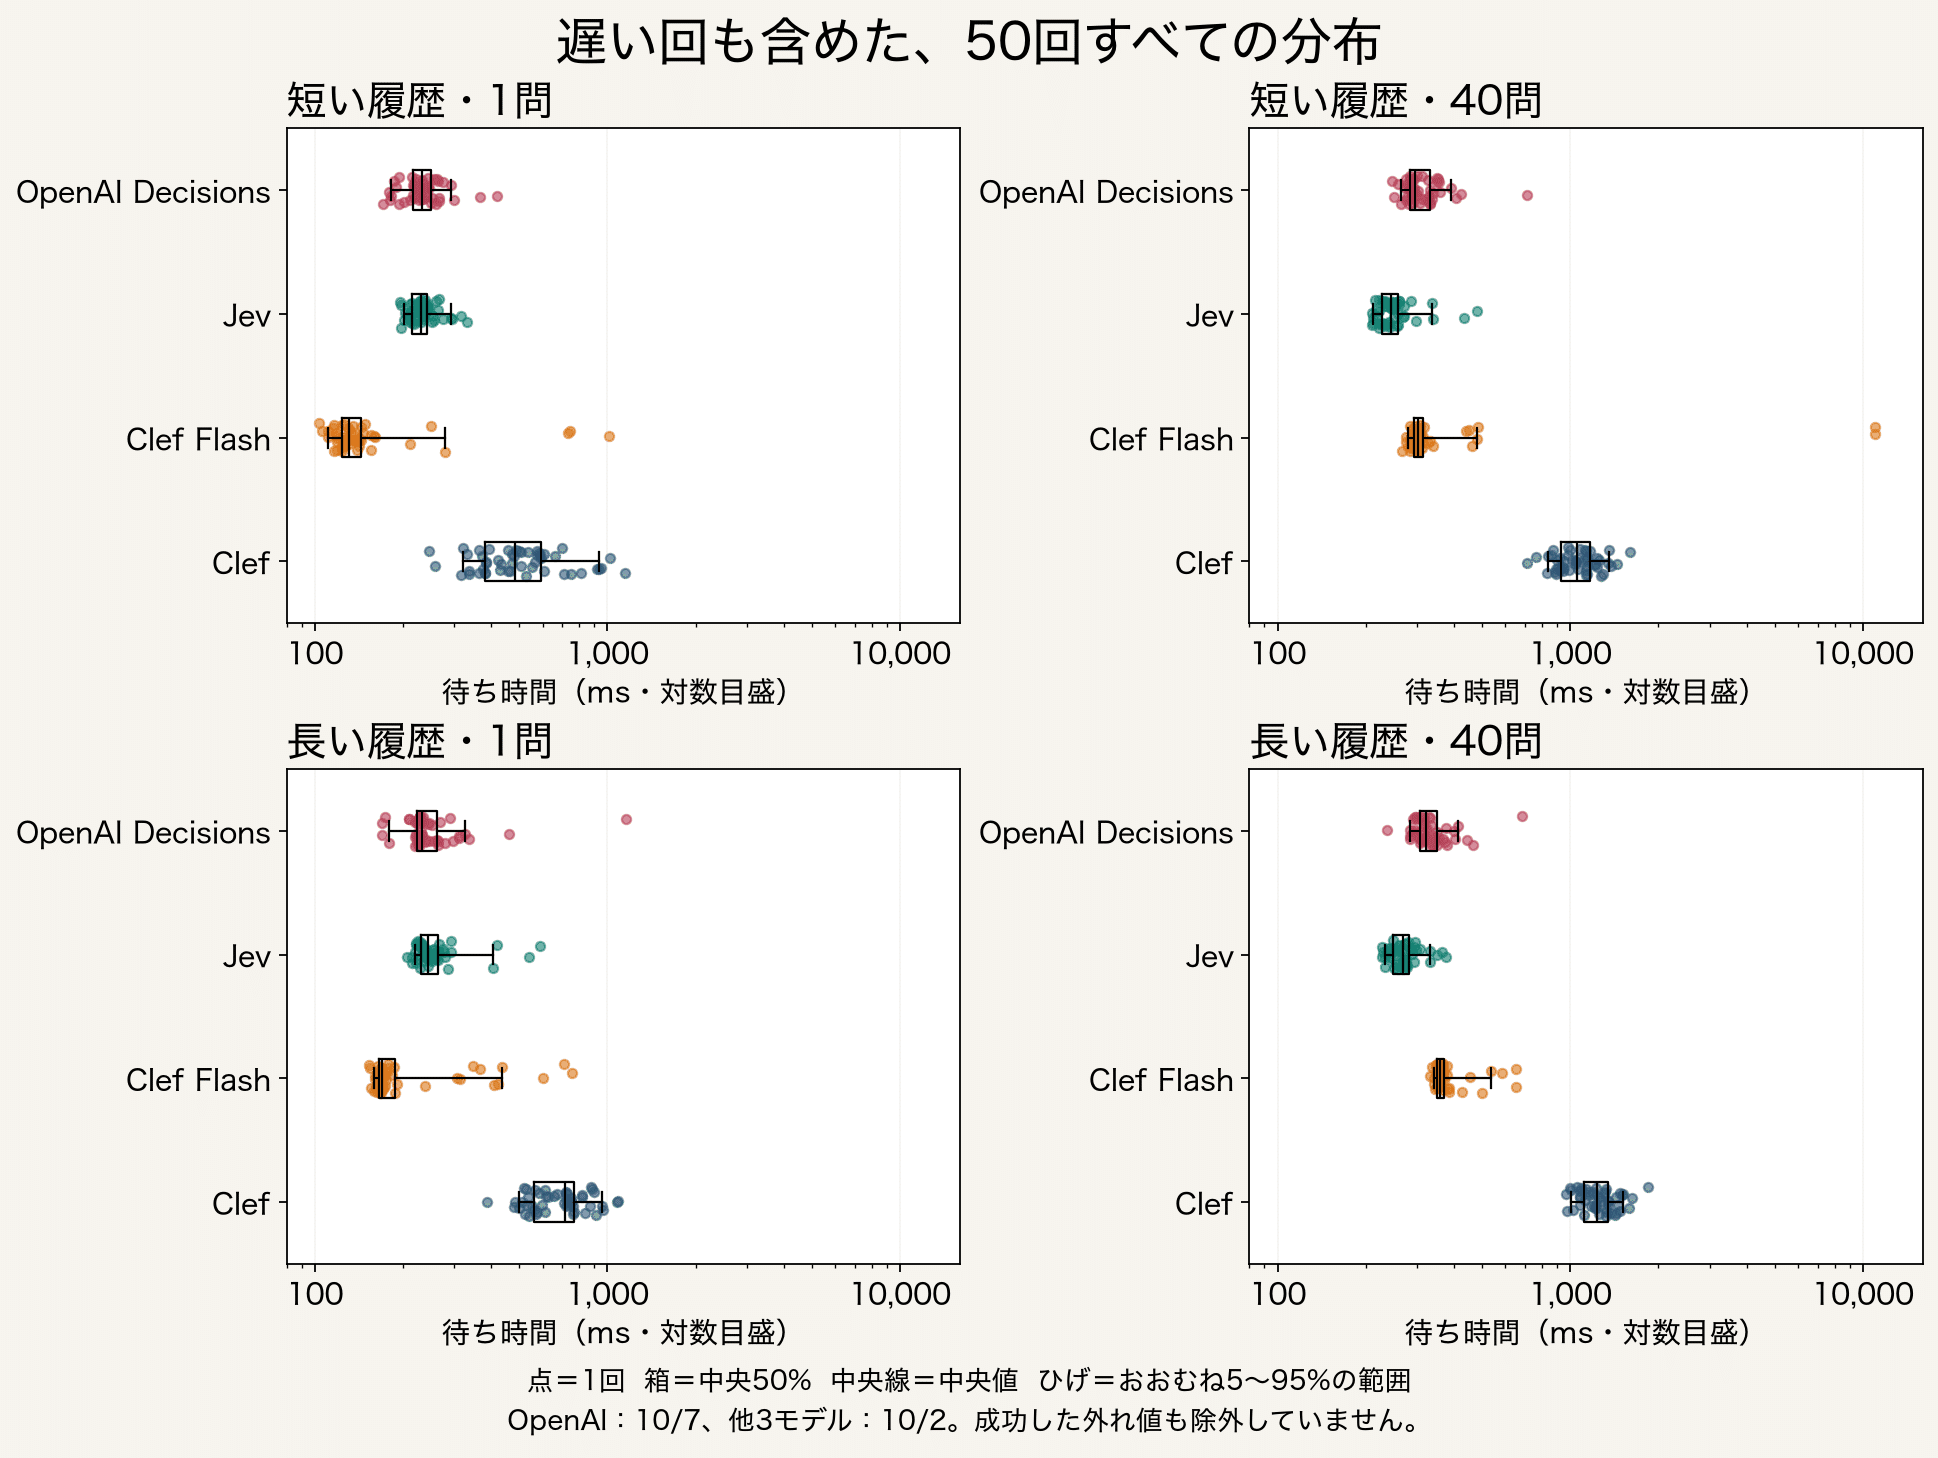
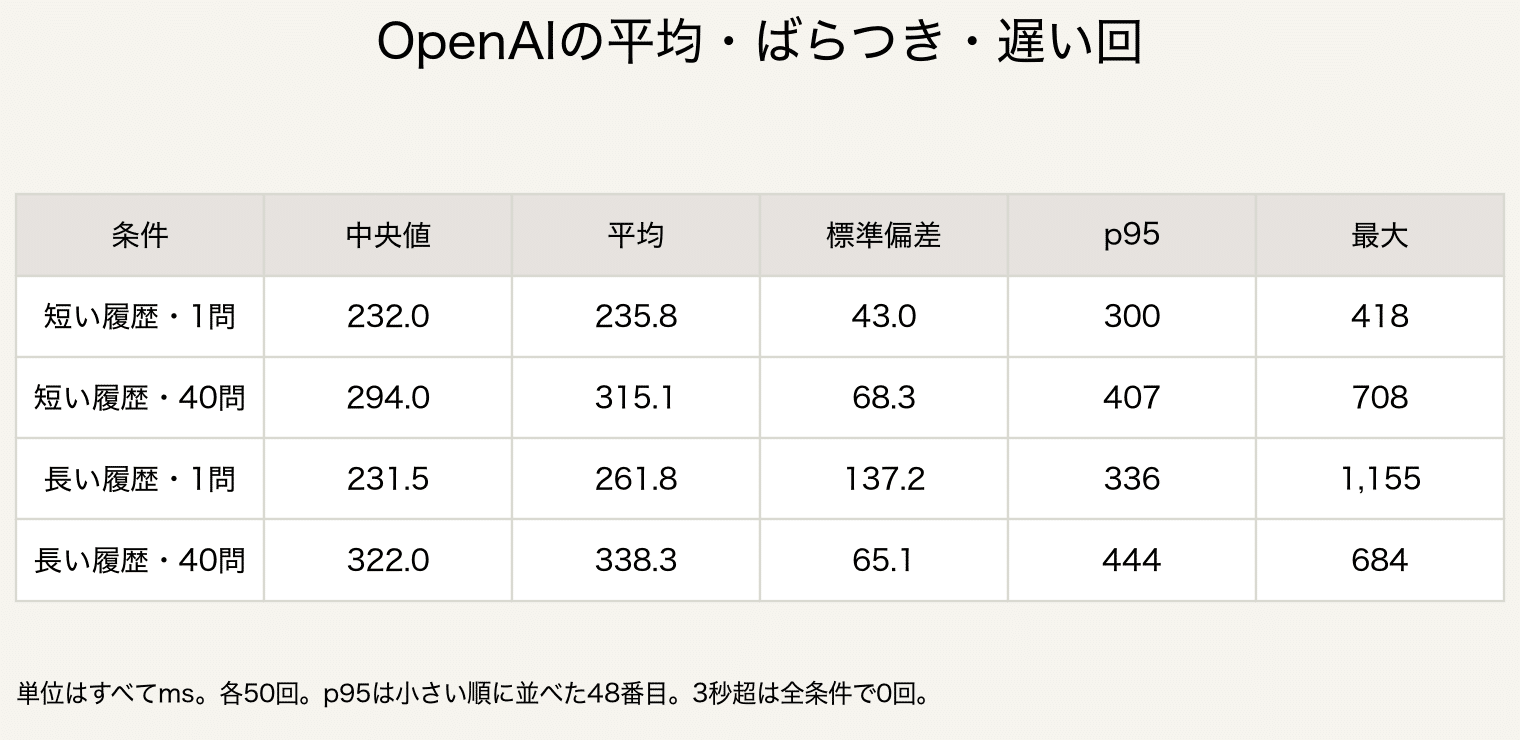
OpenAIの応答時間の平均値は、「短い履歴・1問」が235.8ms、「短い履歴・40問」が315.1ms、「長い履歴・1問」が261.8ms、「長い履歴・40問」が338.3msでした。全200回のリクエストすべてで指定どおりの形式と件数で正常に応答が得られ、3秒を超える極端な遅延は一度も発生しませんでした。最も遅かったケースでも、「長い履歴・1問」の1,155ms(約1.16秒)にとどまっています。
なお、ここでの「3秒超」とは、1回のリクエストに対して応答完了までに3,000msを超えたケースを指しており、HTTPエラーやタイムアウトの発生件数ではありません。
平均値は待ち時間の合計を試行回数で割った値であり、標準偏差は各回の待ち時間のばらつき(安定性)を示します。「長い履歴・1問」では、中央値231.5msに対して標準偏差が137.2msとなりました。これは1秒を超えたケースが一部含まれていたため、他の条件と比べてばらつきがやや大きくなったことを示しています。
標本分散を確認すると、「短い履歴・1問」から順に約1,851 / 4,669 / 18,834 / 4,240ms²でした。分散は標準偏差の2乗値であるため、ミリ秒(ms)単位で直接把握できる標準偏差のほうが直感的に理解しやすいでしょう。なお、p95(95パーセンタイル値)は、50回の測定値を昇順に並べた際の48番目に該当する値です。
今回の検証範囲においては、突発的な大幅遅延(スパイク)は比較的少ないという結果になりました。ただし、今回の200回の試行で発生しなかったからといって、今後の運用において絶対に起きないとは言い切れません。長時間の連続稼働や高トラフィック時の挙動については、今回の測定範囲外である点にご留意ください。
6. コスト比較:100万トークンあたり0.10ドル――同一プロンプトでも消費トークン数は変動
Decisions APIで提供されるgpt-6-lunaの利用料は、公式ガイドによると入力100万トークンあたり0.10ドルです。出力トークン費用やキャッシュの読み書きに対する追加料金はありません。ただし、特定リージョンでの処理指定や長大なコンテキスト長を扱う場合には追加料金が発生する規定があるため、導入時には最新の料金体系をご確認ください。
比較対象とした各モデルの単価(入力100万トークンあたり)は、Jevが0.042ドル、Clef Flashが0.09ドル、Clefが0.24ドルです(いずれも2026年10月2日時点で確認したCloudflare Workers AIの提供価格)。
トークン単価だけで比較すると、OpenAI(0.10ドル)はClef Flash(0.09ドル)とほぼ同水準に見えます。しかし注意点として、まったく同じテキストを入力した場合でも、APIごとに算出・返却されるトークン数は異なります。実際、「長い履歴・40問」の条件において、OpenAIは10,796トークン、Jevは8,290トークン、Clef系は5,720トークンとカウントされました。
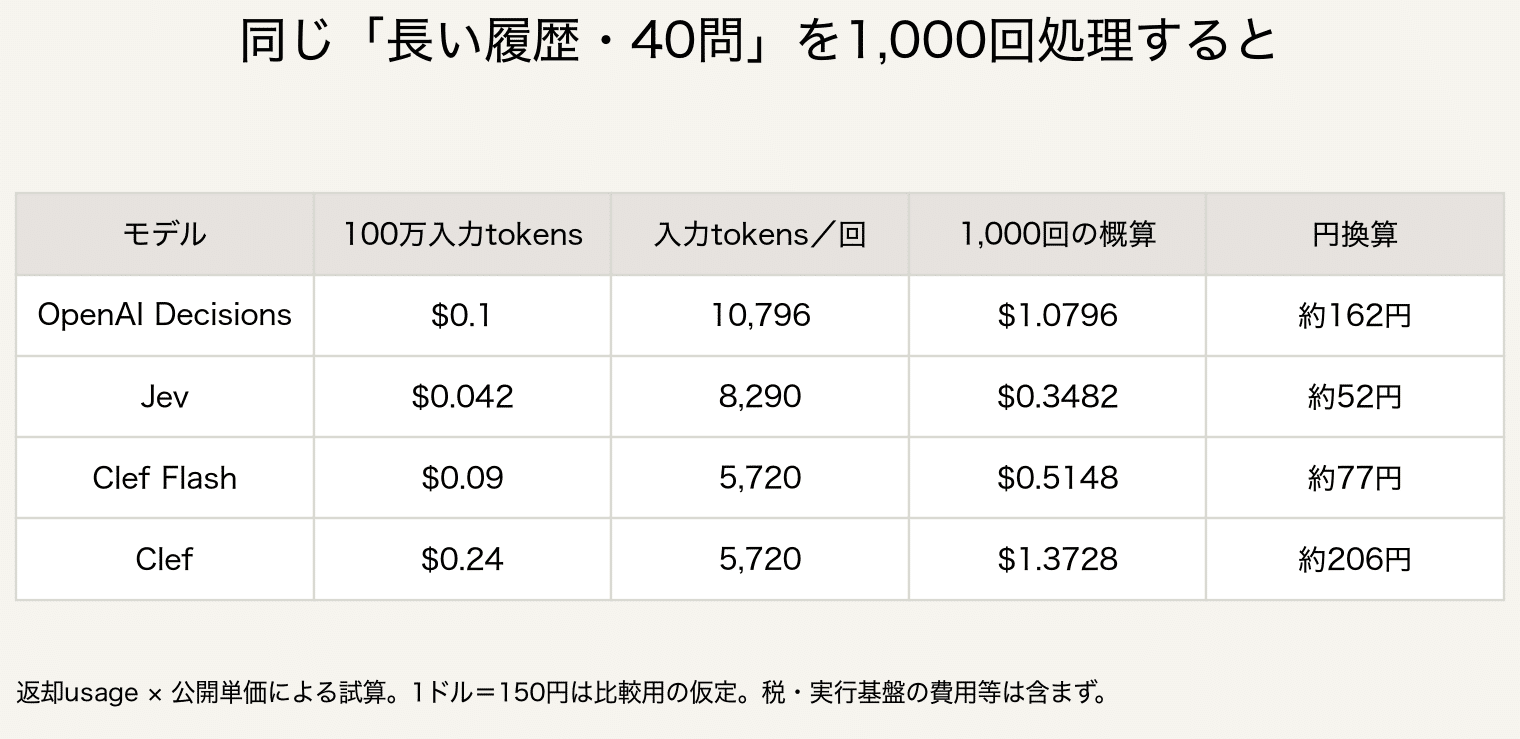
1,000回のリクエストに換算すると、OpenAIは約1.08ドル(約162円)、Jevは約0.35ドル(約52円)、Clef Flashは約0.51ドル(約77円)、Clefは約1.37ドル(約206円)となります(為替レートは1ドル=150円で試算)。
この条件下において、OpenAIはClefより安価であるものの、Clef Flashに対しては約2.1倍、Jevに対しては約3.1倍のコストがかかる計算になります。100万トークンあたりの見かけの単価だけでなく、実際に消費されるトークン数(usage)まで加味して初めて、正確なコストバランスが見えてきます。
トークン数の差には、トークナイザーの仕様やプロンプトの内部展開形式などが影響していると考えられますが、レスポンスに含まれる返却値のみから詳細な内訳を特定することはできません。そのため、異なる形式の入力テキストでも同様の比率になるとは限らない点にご留意ください。なお、今回のテキスト検証では、キャッシュされたトークン数はいずれもゼロでした。
出典:OpenAIの料金 / Cloudflare:Jev / Clef / Clef Flash
7. 画像入力の検証:解像度の上昇に伴うレイテンシとコストの変動
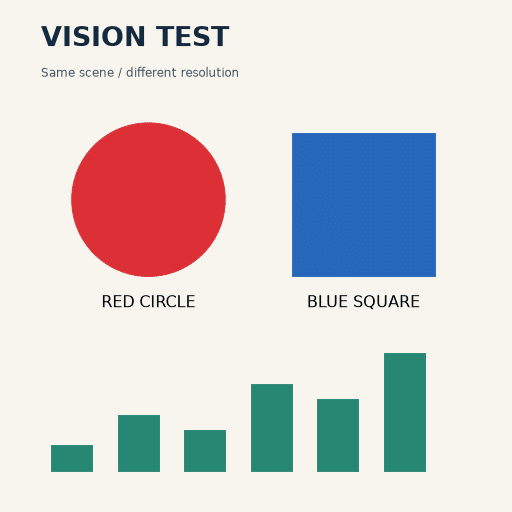
画像入力のテストには、前回と同様に「赤い円」と「青い四角」を配置したPNG画像を使用しました。解像度は256 / 512 / 1,024 / 2,048 / 3,072ピクセル四方の5サイズを用意し、「赤い円が描かれていますか?」「青い四角形が描かれていますか?」という2つの日本語の質問を行いました。
各解像度において初回1回をウォームアップとし、その後の3回を測定対象としました。また、比較用として画像を含まないリクエストも測定しています。なお、テキストの50回試行とは異なり、画像は各条件3回の試行にとどまるため、レイテンシのばらつきや遅延の発生率を評価するためのサンプル数としては限定的である点をご承知おきください。
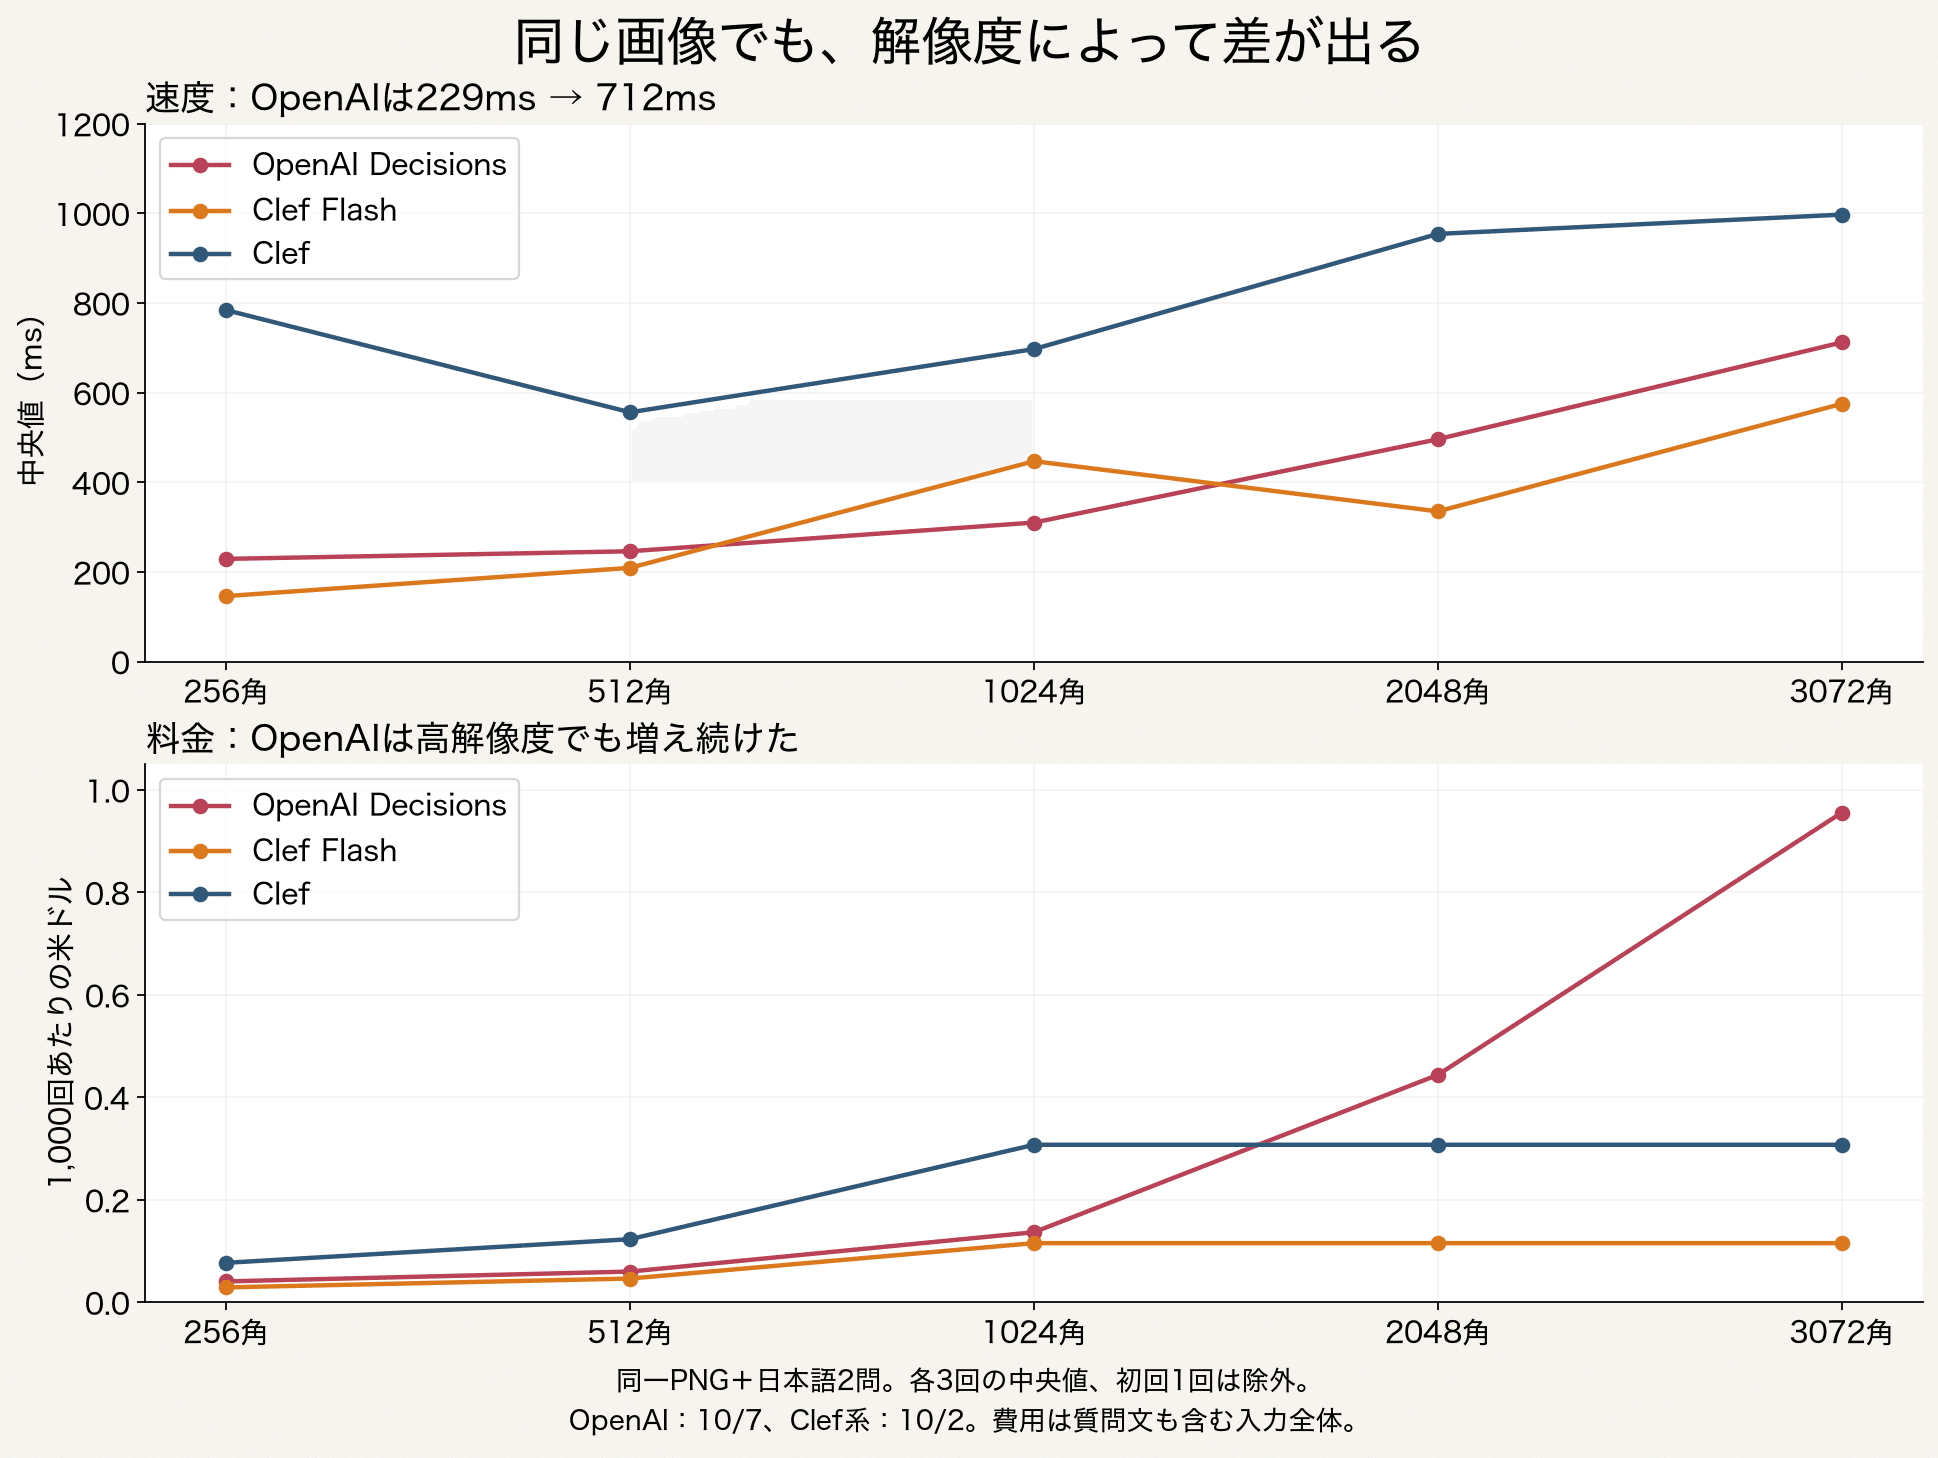
OpenAIの応答時間の中央値は、256ピクセル四方で229ms、512ピクセル四方で246ms、1,024ピクセル四方で310ms、2,048ピクセル四方で496ms、3,072ピクセル四方で712msとなりました。今回のテスト画像では、解像度の上昇に伴って待ち時間が増加する傾向が見られます。
入力トークン数については、画像なしのテキストのみで340トークンでした。これに画像を追加すると、256ピクセル四方で405、512ピクセル四方で597、1,024ピクセル四方で1,365、2,048ピクセル四方で4,437、3,072ピクセル四方では9,557トークンまで増加しました。
ここで前回のClefとの明確な挙動の違いが確認されました。Clef / Clef Flashでは、1,024ピクセル四方以上でトークン数が1,280で頭打ちになっていたのに対し、OpenAIは2,048ピクセル四方や3,072ピクセル四方でも解像度に応じてトークン数が増え続けています。
3,072ピクセル四方の画像を1,000回判定させた場合のコストを試算すると、OpenAIは約0.956ドル(約143円)、Clefは約0.307ドル(約46円)、Clef Flashは約0.115ドル(約17円)となります。高解像度の画像を大量かつ継続的に処理する業務においては、このコスト差が重要な判断材料となります。
ただし、同じPNG画像を送信していても、各モデルの内部でどのような解像度やパッチ分割で前処理されているかはブラックボックスです。したがって、トークン数が多いからといって「細部まで高精度に認識できている」とは言えず、逆にトークン数が少ないからといって「品質が劣る」とも判断できません。微細な文字の読み取りや微小な欠陥の検知といった実務要件に対しては、個別の精度検証が不可欠です。
8. 判定精度の比較:日本語100問および図形画像30種類による検証
応答が速くても、判定結果が間違っていては困ります。そこで速度検証とは別に、あらかじめ正解を決めた「日本語テキスト100問」と「図形画像30種類」を用意し、4モデルの判定精度を追加検証しました。
日本語100問の検証結果:Clefが100問、Jevが98問、Clef Flashが93問、OpenAIが90問正解
テキスト課題は、「返信の要否」「緊急度の判定」「経費申請の承認可否」「スケジュールの期日判定」「最新ログの条件適合性」の5分野から各20問、計100問で構成しました。判定ルールと判定対象のテキストをプロンプトとして同時に与え、指示されたルールを正確に遵守できるかを検証しています。各分野の正解は肯定(True)10問・否定(False)10問の均等配置とし、常に「はい」と答えるような偏りでは正解率が上がらないよう設計しました。
各モデルに対して同じ問題を1回ずつ入力し、返却された確率値が0.5以上の場合を「肯定」と判定しました。プロンプト内には正解例や解説を一切含めず、また検証結果を受けて問題文や評価基準を後から調整するような操作も行っていません。
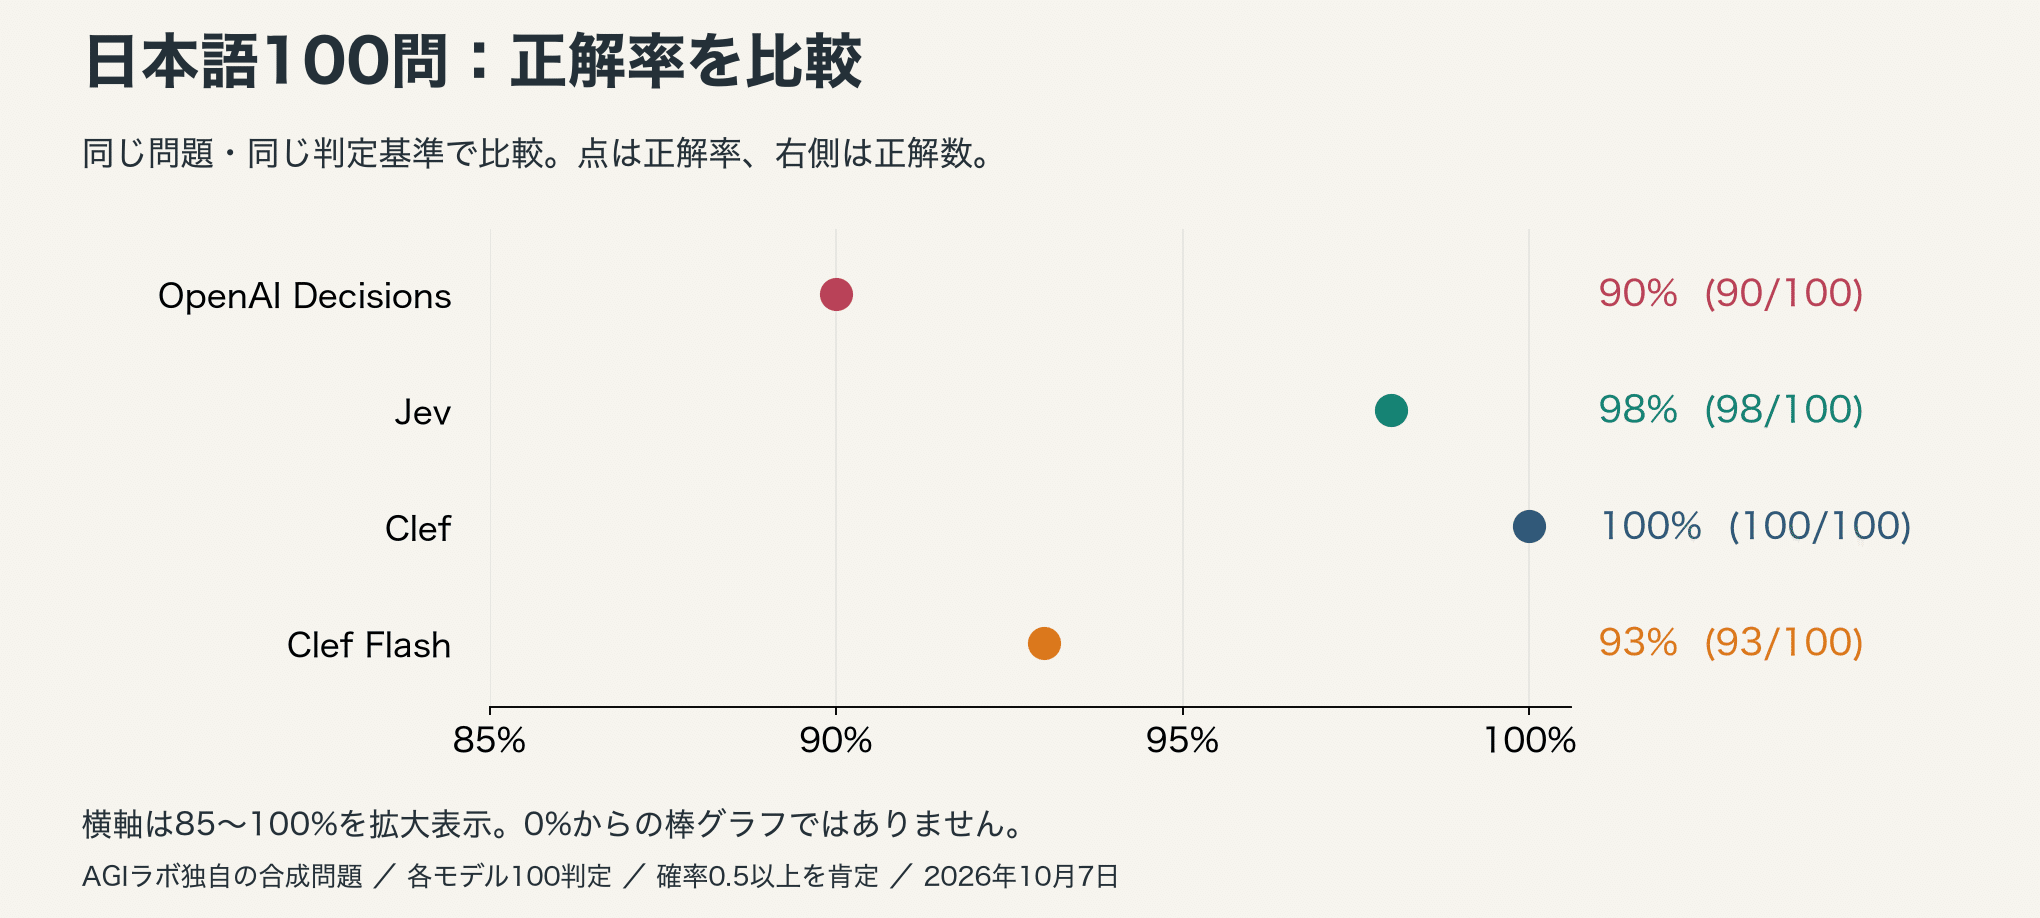
今回の100問の検証において、Clefは100問全問正解、Jevは98問正解という極めて高い精度を記録しました。一方、Clef Flashは93問、OpenAIは90問という結果でした。なお、OpenAIとClef Flashの差はわずか3問であり、このデータのみをもって両モデルの全般的な優劣を判断することは困難です。
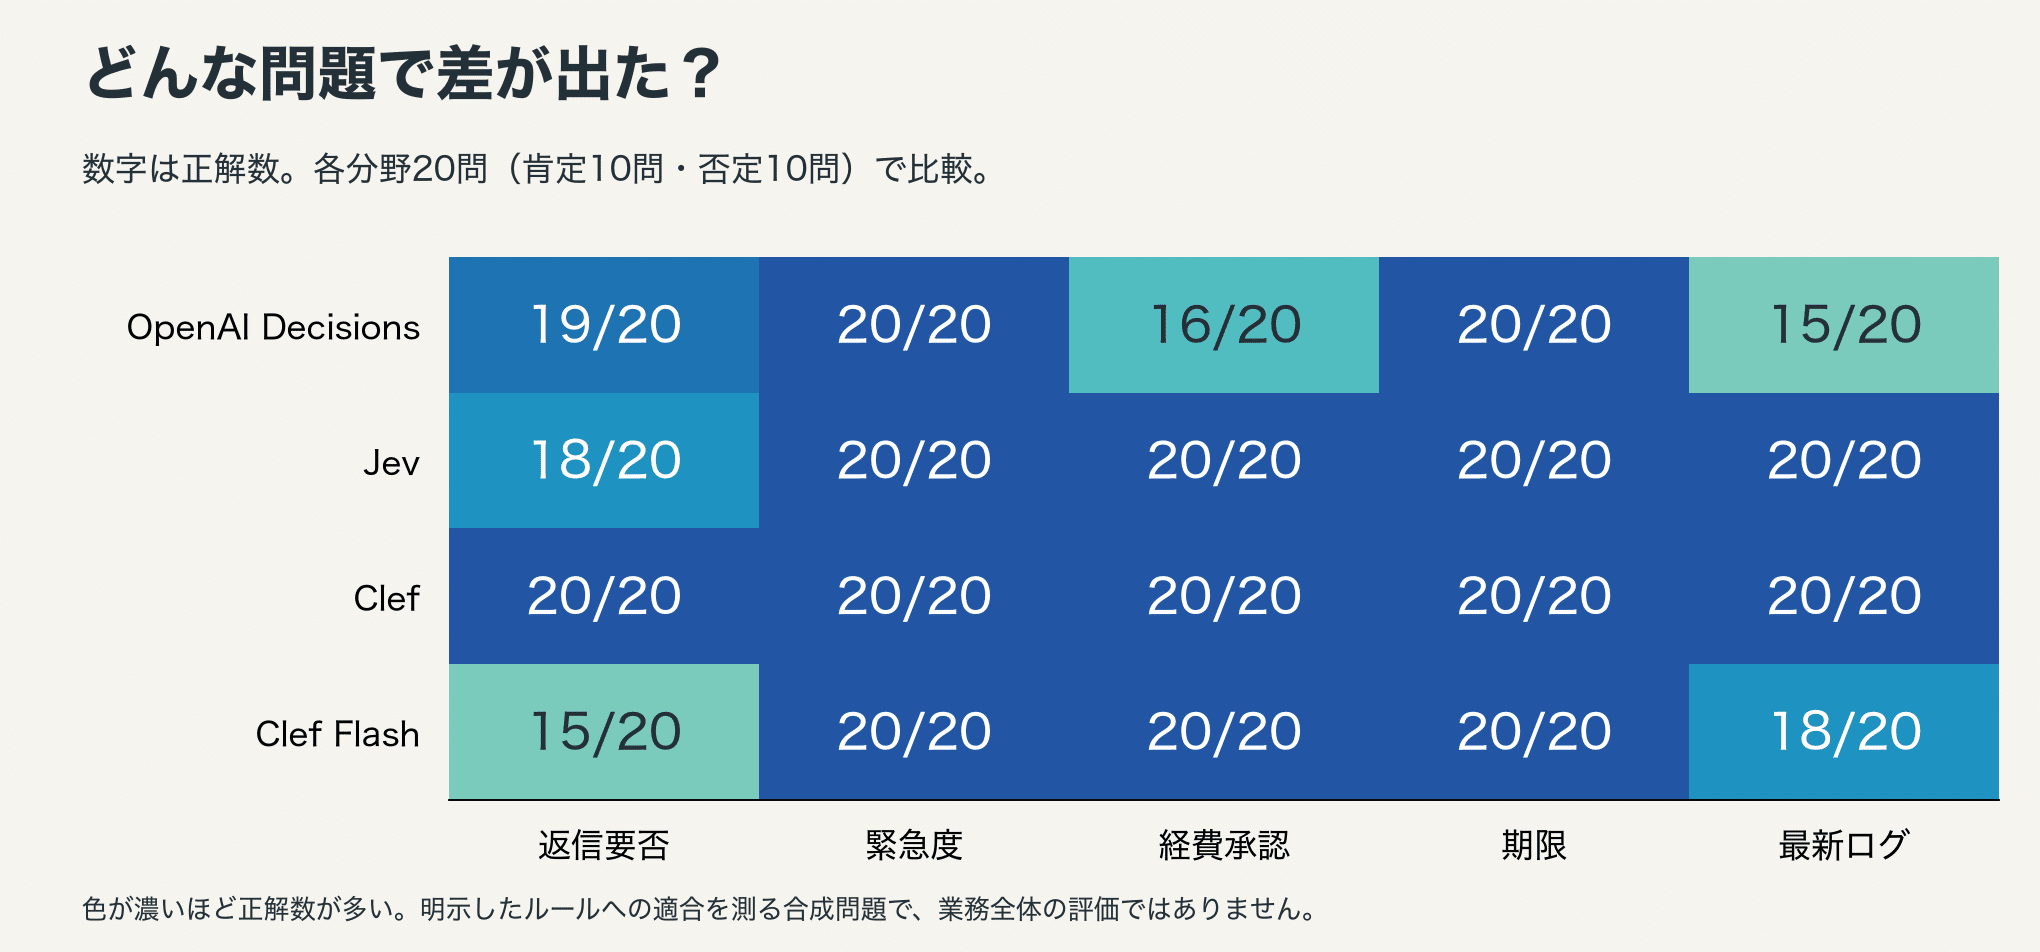
モデル別の内訳を見ると、OpenAIは「緊急度」と「期日判定」で全問正解(20/20)を達成した一方、「経費承認」は16/20問、「最新ログ」は15/20問にとどまりました。具体例として、「承認可能な上限額は1万円以下」という明確なルールに対し、1万1円の申請を「承認可能」と誤判定したケースがありました。また「最新ログ」の検証では、実際には条件を満たしているログを「満たしていない」と判定する誤りが5件生じています。
Jevの誤答2件は、いずれも「返信要否」に関するものでした。これは、メール本文中に特定の人物名が登場していることと、その人物自身が返信すべき宛先であることの違いを識別する問題です。Clef Flashでも、「返信要否」で5件、「最新ログ」で2件のエラーが見られました。金額の境界値判定、名指しされた宛先の識別、時系列ログの解釈など、モデルが「どのような文脈で誤認しやすいか」を把握することは、実業務への導入において重要な評価ポイントとなります。
なお、この100問を処理した際の応答時間の中央値は、Clef Flashが107ms、Jevが210ms、OpenAIが237ms、Clefが373msでした。今回のデータセットにおいては、Clefが最も高い精度を示し、Clef Flashが最も高速に処理を完了したことになります。ただし、本テストは前半の「40問一括判定」とは入力テキストや質問数が異なるため、独立した測定結果として捉える必要があります。
画像検証では対象の有無だけでなく、数量・位置関係・小さな図形の色も確認
前節で用いた「赤い円・青い四角」の画像では、OpenAIおよびClef系の全モデルが全30回の判定すべてで正解しました。しかし、これは同一の単純な画像を用いた動作確認にすぎません。そこで追加検証として、30種類の図形画像を作成し、「特定の図形の有無」「青い四角の個数」「図形同士の左右の位置関係」「右上の枠内に配置された小さな四角形の色」を問うテストを実施しました。
1枚の画像につき4つの質問を設定し、各項目の正解は肯定15件・否定15件に均等化しました。同一の30パターンについて、256 / 512 / 1,024ピクセル四方の3つの解像度を用意し、OpenAI、Clef、Clef Flashの3モデルに各1回ずつリクエストを送信しました。各モデル・各解像度あたり120判定、全体で計1,080回の判定結果を採点しています(Jevは今回の画像比較には含めていません)。
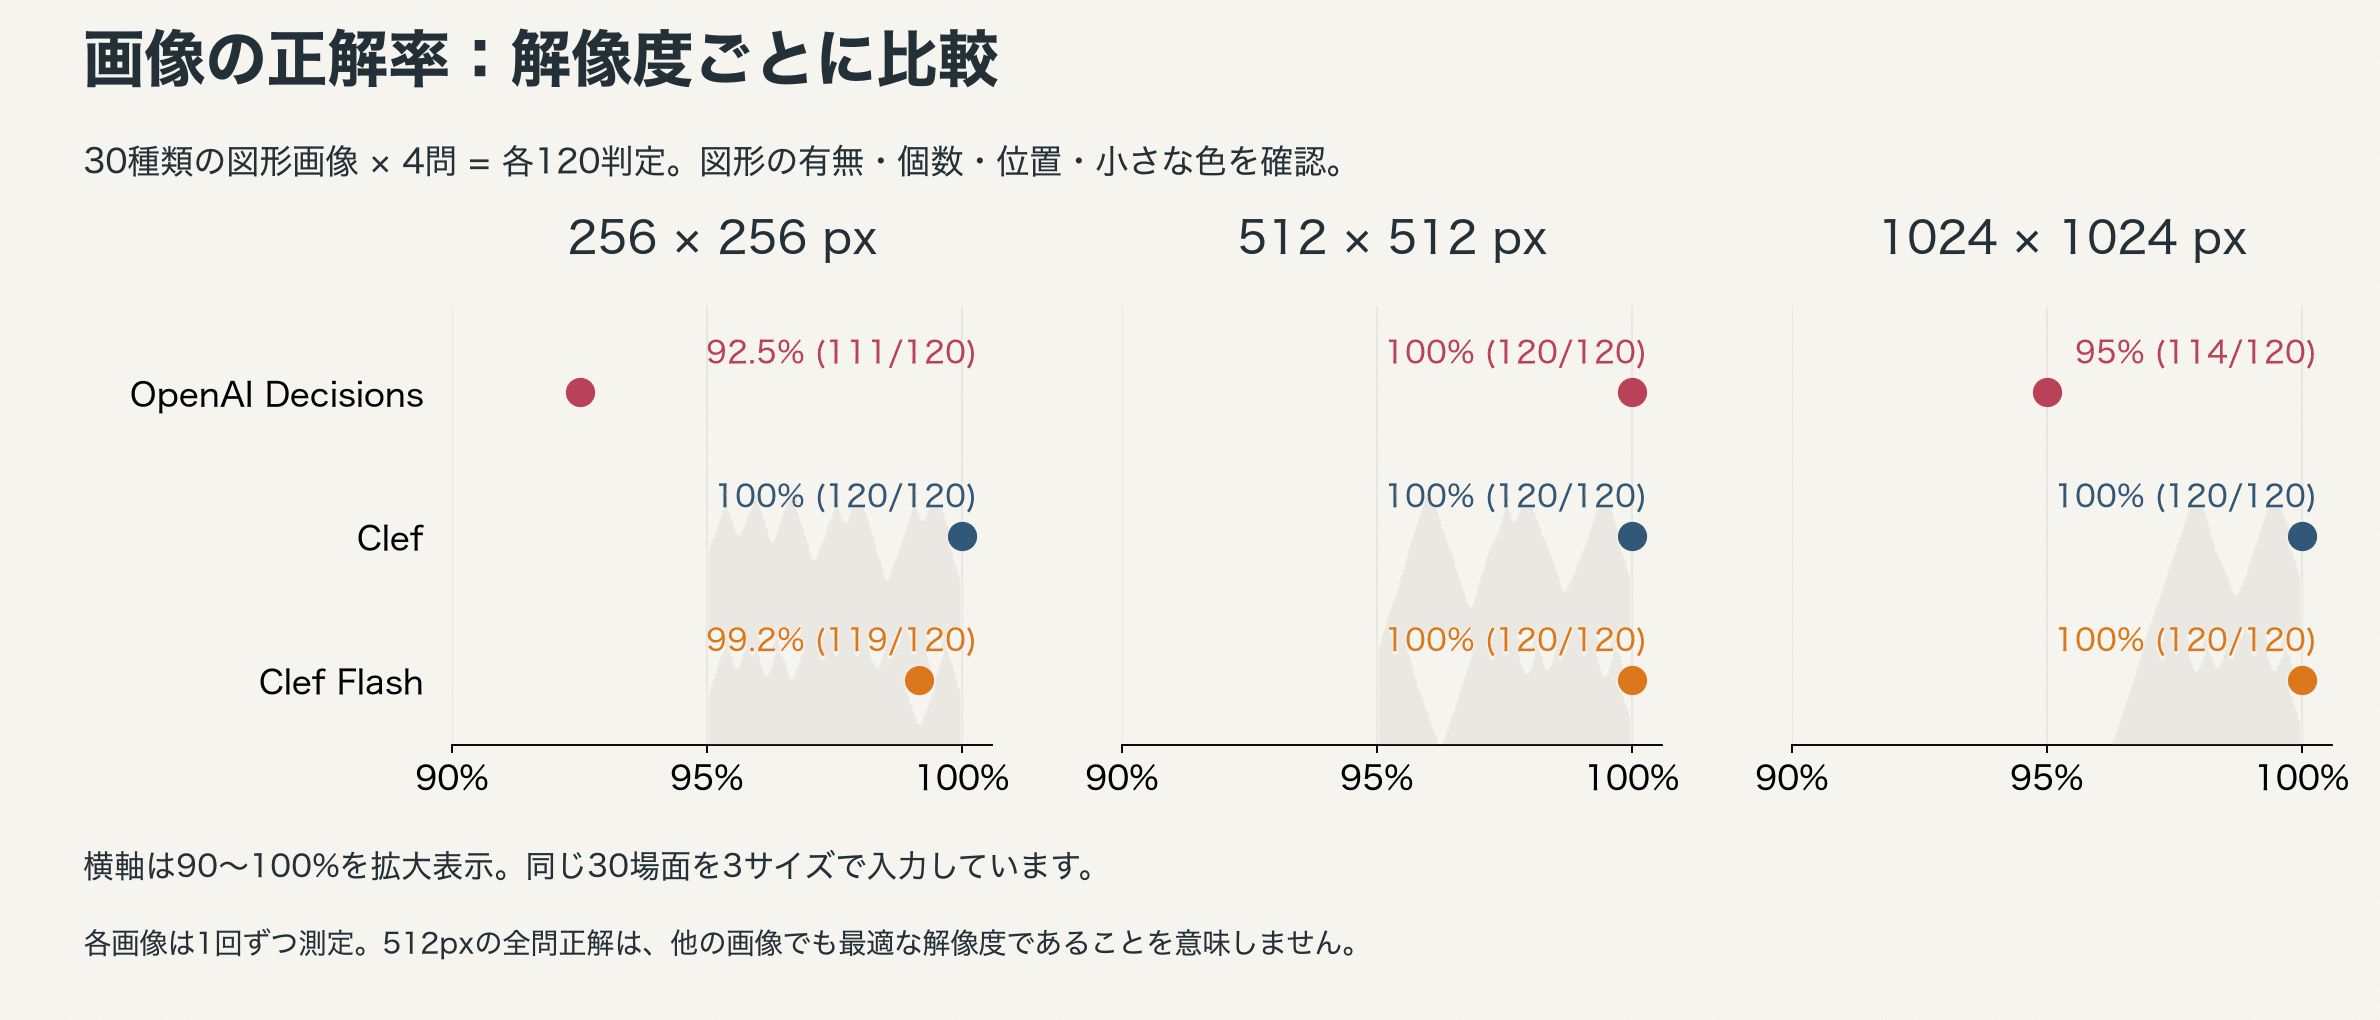
結果として、Clefは3サイズすべてで120/120問全問正解を記録しました。Clef Flashも、256ピクセル四方で119/120問、512ピクセルおよび1,024ピクセル四方では120/120問全問正解と極めて高い精度を示しました(256ピクセル四方での1件の誤答は、小さな四角形の色を識別する問題でした)。
一方、OpenAIの正解率は、256ピクセル四方で111/120問(92.5%)、512ピクセル四方で120/120問(100%)、1,024ピクセル四方で114/120問(95.0%)となりました。256ピクセル四方における誤答9件はすべて「図形の左右関係」に関するものでした。また、1,024ピクセル四方では「左右関係」で4件、「個数のカウント」で2件の誤判定が発生しています。
今回の測定では、「解像度を引き上げれば必ず認識精度も向上する」という結果ではありませんでした。ただし、本検証は各画像を1回ずつ評価した結果であるため、「512ピクセル四方が最も適している」「1,024ピクセル四方にすると精度が落ちる」と一般化することはできません。より確かな傾向をつかむには、画像のバリエーションを増やし、同一条件下での試行回数を重ねた継続的な検証が必要です。
今回の検証結果から、どこまで言えるのか
今回作成した合成データセットにおいては、Clefがテキスト・画像ともに全問正解という優れた結果を残しました。しかし、この数値をそのまま「実際の業務でも100%の精度を発揮する」と解釈することはできません。テキストデータは共通のテンプレートをベースに条件を一部変更した50組のペアデータであり、画像データも定型の構図に幾何学図形を配置したものです。現実の多様な問い合わせ文や実写写真、複雑なUI画面、OCR(文字認識)などを網羅的に検証したわけではない点に注意が必要です。
また、APIが返却する「確率0.99」という数値は、「現実世界の判定として99%正確である」ことを保証するものではありません。今回の実験でも、高い確信度を示しながら実際には誤判定していたケースが見られました。実システムへ組み込む際には、単なる総合正解率だけでなく、「承認してはならないものを誤って承認してしまうリスク(偽陽性)」と「対応すべき重要な案件を見落としてしまうリスク(偽陰性)」を明確に区別して評価することが極めて重要です。
今回評価したのは、プロンプト内で明示されたビジネスルールをテキストから忠実に解釈・適用する能力です。金額の大小比較や日時の整合性など、従来のプログラム(確定的なロジック)で確実に判定できる処理については、コード側で検証するアプローチも併用できます。どこまでをAIの推論に委ね、どこを確定的なロジックで制御するかを適切に切り分けた上で、実際の自社データを用いたPoC(概念実証)を行うことが推奨されます。
精度試験の測定メモ:2026年10月7日、日本国内のCloudflare拠点(NRT)から順次実行。テキスト100問×4モデルで400回、画像30種類×3解像度×3モデルで270回、合計670回のAPI呼び出しから得た判定結果を採点(各モデルにつきテキストで1回のウォームアップを別途実施)。テスト問題および正解ラベルは実行前に確定させ、実行順序は問題およびモデルごとにシャッフルして実施。APIエラーや出力スキーマの不備はゼロ件でした。ウォームアップを含む全API利用コストは、返却されたusage値と公開単価に基づく試算で約0.051ドル(1ドル=150円換算で約7.6円)でした。
9. 実装方法:判断材料と質問パラメータを渡すだけのシンプルな構造
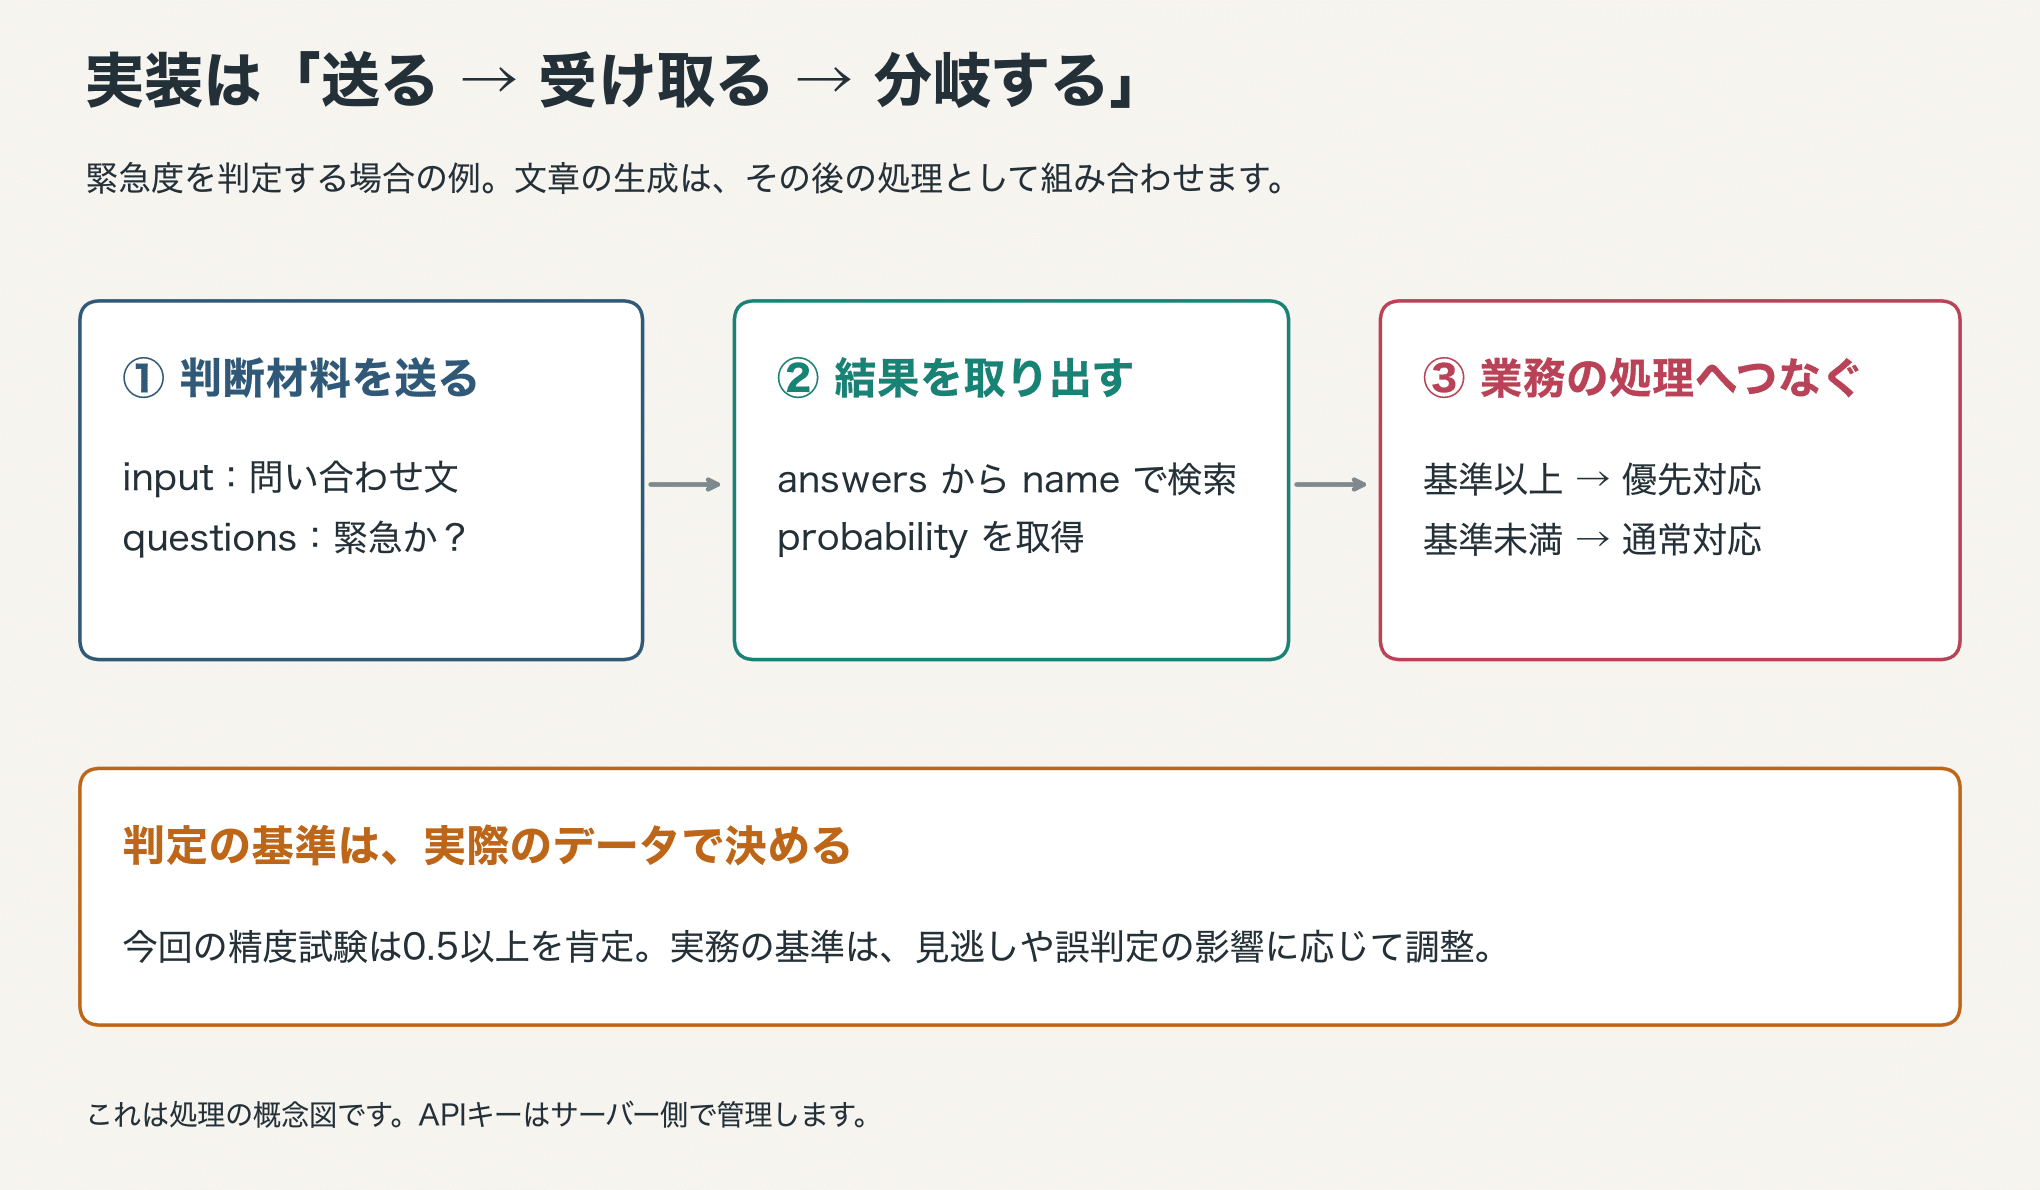
基本的な実装手順は非常にシンプルです。以下は、問い合わせ内容から緊急度を判定するサーバーサイドJavaScript(Node.js等)の最小限のコード例です(※入力テキストは解説用のダミーデータであり、前述の200回測定で使用したログデータとは異なります)。
const res = await fetch("https://api.openai.com/v1/decisions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    model: "gpt-6-luna",
    input: "決済が3日間失敗しています。至急確認してください。",
    questions: [{
      name: "is_urgent",
      type: "predicate",
      instructions: "この問い合わせは緊急対応を求めていますか?",
    }],
  }),
});
if (!res.ok) throw new Error(`API error: ${res.status}`);
const { answers } = await res.json();
const answer = answers.find(x => x.name === "is_urgent");
console.log(answer.probability);
既存のJevやClefから移行する場合、判断材料として渡していたstateをinputに対応させ、質問群を名前(キー)付きの配列として渡す設計に変更します。レスポンスも配列形式で返却されるため、各要素のnameを参照して対応する判定結果を取得します。単にプロパティ名を置き換えるだけでなく、レスポンスのパース処理にも修正が必要となる点にご注意ください。
画像は input_image として、Base64のdata URLで送信します。現時点の公式仕様では、外部の画像URLや file_id をそのまま渡す方式には対応していません。画像ファイルを読み込んで送る例は公式ガイドにあります。
10. 想定されるユースケースと採用の判断基準
今回の検証結果を踏まえると、Decisions APIは、すでにOpenAIのエコシステムを採用しているシステムへ「迅速な判定処理」を組み込みたい場合に有力な選択肢となります。具体的には、問い合わせの緊急度を判定した上で優先的に返信文を生成するワークフローや、AIエージェントのコンテキスト履歴を整理してから次の推論ステップへ進むような構成が考えられます。また、画像入力にも対応しているため、画面キャプチャ内に特定のUI要素やエラー表示があるかを素早く検知する用途にも応用が期待できます(※これら個別のユースケース自体を本検証で直接評価したわけではありません)。
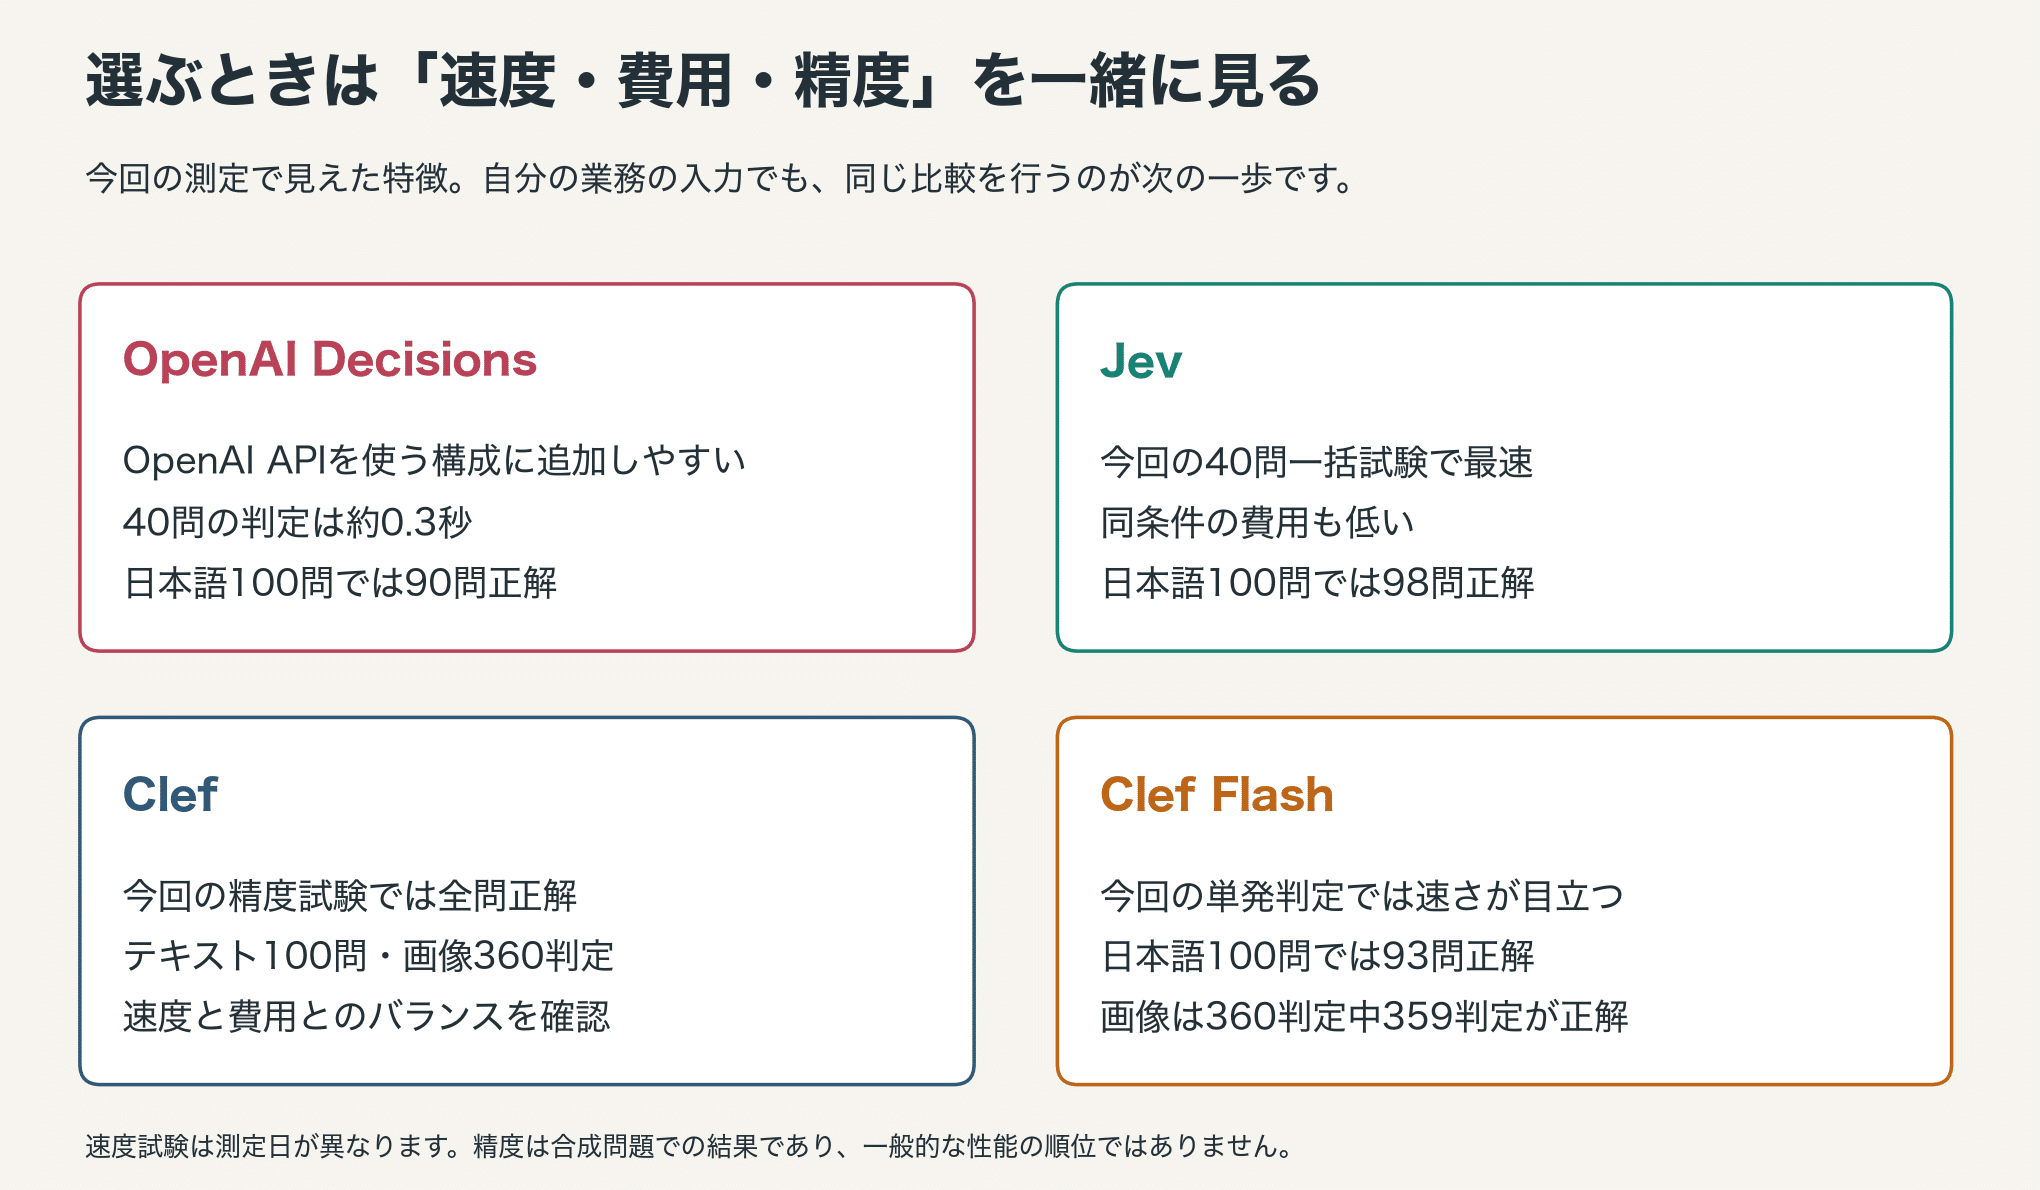
一方で、今回実施した「40問の一括判定」においては、Jevのほうが高速であり、コスト効率にも優れていました。また、単発の判定処理においてはClef Flashの応答の速さが際立っています。さらに、高解像度の画像を大量に処理する業務では、解像度の上昇に伴うコストの増加傾向もモデル選定における重要な比較ポイントとなります。
加えて、APIの呼び出し元となるロケーションの影響も無視できません。今回の検証はすべて日本国内のエッジ拠点(NRT)から呼び出していますが、実際に推論処理を実行したサーバーやGPUの物理的な設置場所までは特定できていません。日本国内と米国内の環境を厳密に揃えて比較測定したわけではないため、今回の速度差を「米国サーバーとの物理的距離(ネットワーク遅延)だけが原因である」と安易に断定することは避けるべきです。
Jev、Clef、そして今回のDecisions APIの登場により、判定特化型AIの選択肢は着実に広がり、用途や要件に応じた比較検討が可能になってきました。OpenAIのDecisions APIは、日本語の複数質問を約0.3秒で一括判定できる高いパフォーマンスを示した一方、今回の合成データによる精度検証ではClefやJevの正解数が上回る結果となりました。処理速度や利用料金の比較にとどまらず、自社の実業務において「どのような誤判定が最も致命的になるか」という許容リスクを見極めた上で、最適なAPIを選定することが重要です。
前半の速度・画像入力試験の測定メモ:OpenAIは2026年10月7日(日本時間)、比較対象は10月2日。テキストは4条件×50回、各条件2回のウォームアップを除外。画像は5解像度+画像なしを各3回、各条件の初回1回を除外。推定費用は返却usageと公開単価から計算し、税・無料枠・割引・実行基盤の費用は含めていません。この速度・画像入力試験のAPI費用は、ウォームアップ込みで約0.127ドルでした。