11月18日に GPT-6.2 Astra・Sol、翌19日に Gemini 4 Neon が発表されました(日本時間)。
まずは、AGIラボで毎日集計している「AGI Radar」を開いてみました。
画面がこちらです。
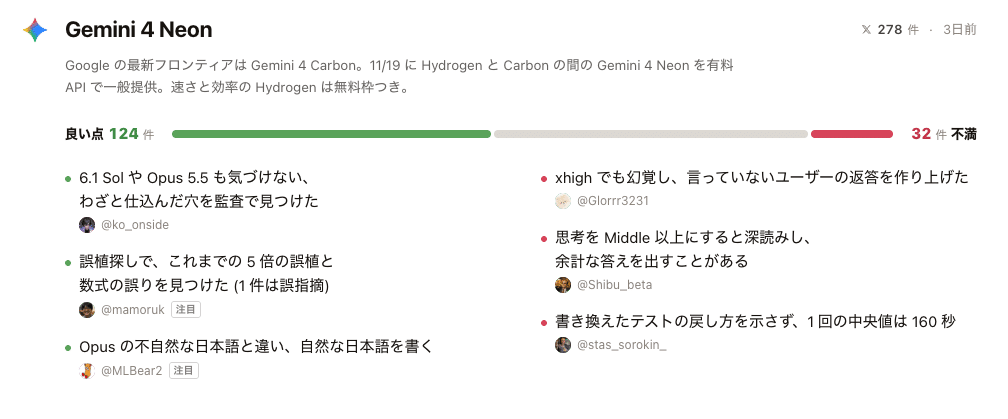
Gemini 4 Neon は良いの割合が79%(良い124・不満32)と高めです。
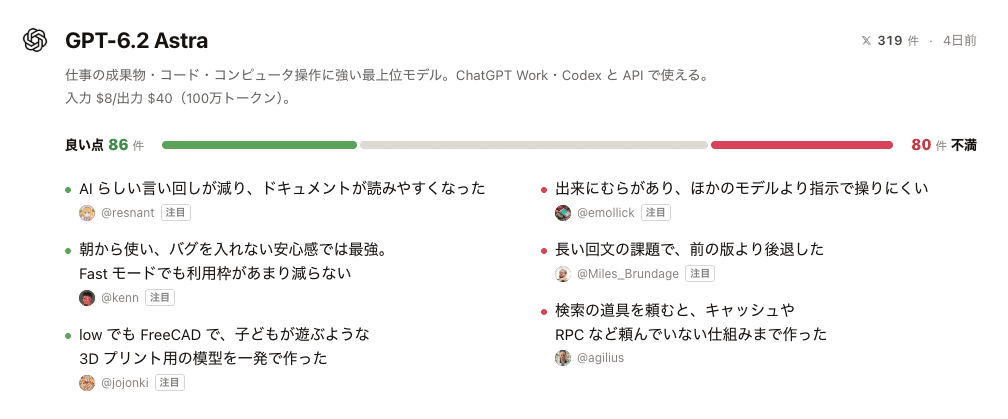
一方、GPT-6.2 Astra は52%(良い86・不満80)と評価が真っ二つに割れました。
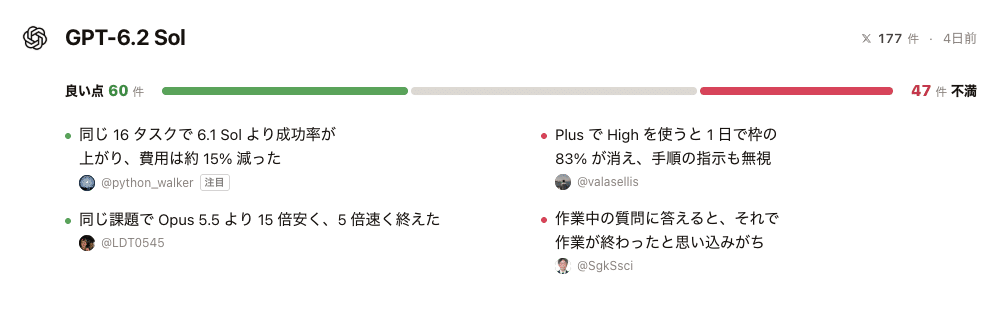
GPT-6.2 Sol は56%(良い60・不満47)で、安さや速さを推す声と、手順の無視を指摘する声が並んでいます。
公開直後から、海外のアーリーテスターや実使用者のあいだで厳しい声が相次いだためです。
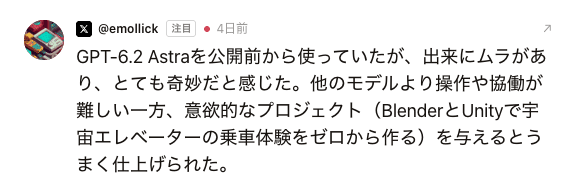
ウォートン校の Ethan Mollick 氏は、操作や協働の難しさを挙げつつ、大きな課題は仕上げられたと書いています。
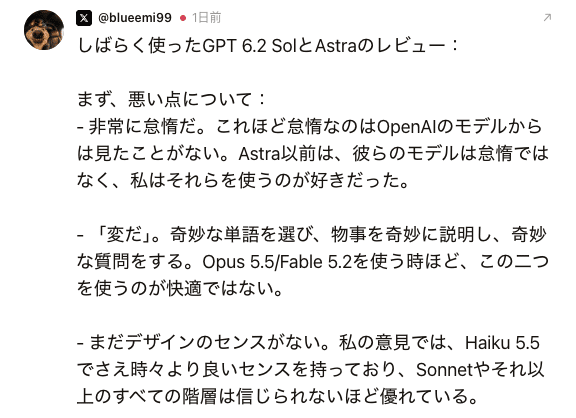
ほかにも開発者の Theo 氏らが長い作業で止まる癖や説明の読みにくさを指摘し、実使用者からも「非常に怠惰だ」という声が目立ちました。
これに対し OpenAI の Sam Altman CEO も「使いやすくする仕事が残っている」と認めています。
Anthropic の上場直前だったこともあり、X では「情報戦が仕掛けられたのでは」という根拠のない憶測まで飛び交いました。
私自身が触ってみても、たしかに癖のあるモデルだと肌身で感じました。
詳しく見ていきましょう。
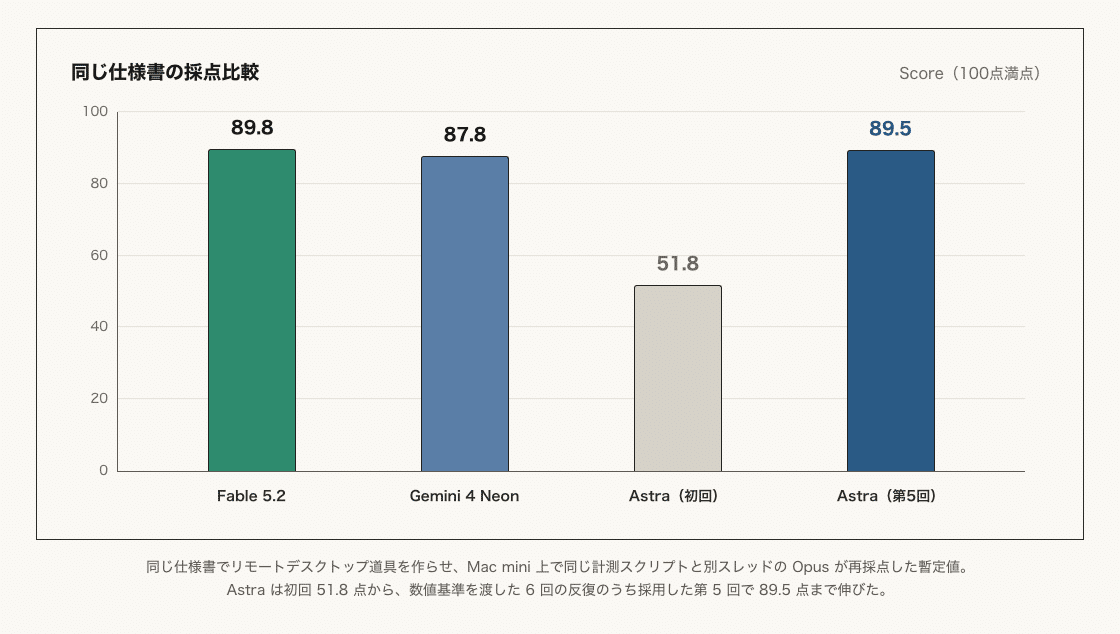
51.8 点の Astra が、採用した第 5 回で 89.5 点になった
今回やってみたのは、別の Mac のデスクトップをブラウザから人もエージェントも操作できる道具を作る課題です。
結果がこちらでした。
実験の概要はシンプルです。
対象モデル:Fable 5.2、GPT-6.2 Astra、Gemini 4 Neon の3つ
共通の条件:待ち受けはローカルか Tailscale のみ、トークン必須、外部リレーなし
進め方:仕様の整理から実装まで、それぞれ1人で作り切る
採点方法:Mac mini 上で同じ計測スクリプトと別系統の Opus が同じ物差しで測り直す
11月19日から20日にかけて行いました。
初回は Fable 5.2 が89.8点、Neon が87.8点と並ぶなか、Astra は51.8点に沈みました。
Astra 側の計測では、画面更新は3.18 fps、クリックしてから画面が変わるまで308 ms かかっています。
実用には遠い数字です。
ここで私は、Astra を切る代わりにこう指示しました。
「Astra を Push してください。明確な基準を出したらできる子」
口調は悪いのですが、Astra や Sol は最初の指示に対してサボるモデルだと感じています。
そこで、曖昧な言葉をやめて数値の合格基準だけを渡しました。
クリックから画面変化まで35 ms 以下、動作時 CPU 6%以下、独立エージェントの操作試験4/4。
改善を繰り返し、5回良くならなければ止める条件で回させました。
結果は、はっきり出ました。
Neon に図解してもらいました。
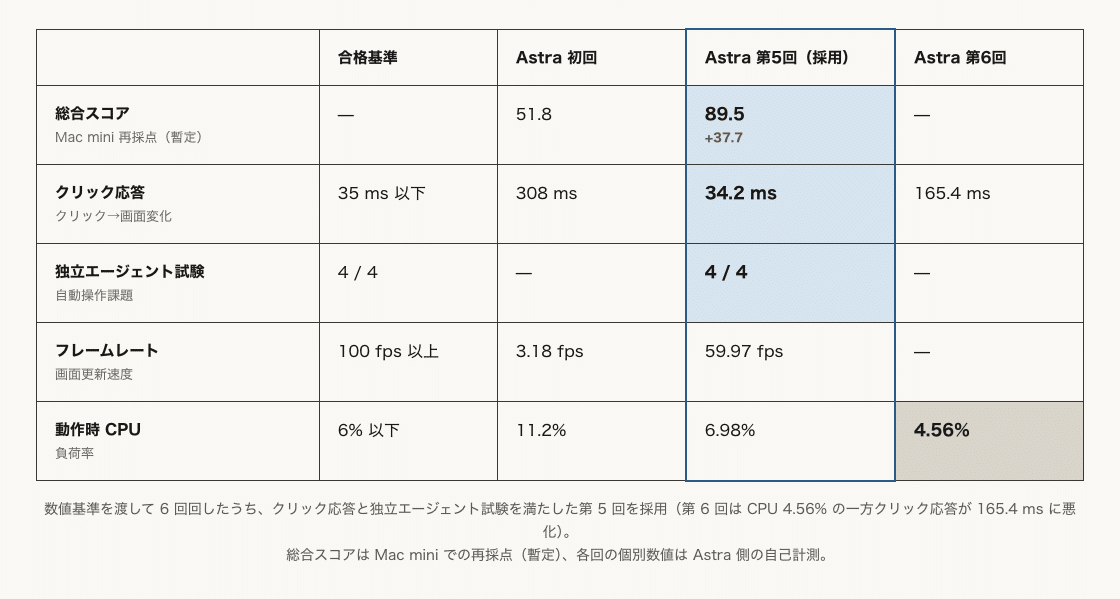
6回回して止めたうち、最も出来の良かった第5回を採用しています。
ブラウザのクリック応答は308 ms から34.2 ms まで縮まり、独立エージェント試験も4/4を通りました。
Mac mini の同じ物差しで測り直した暫定スコアは、89.5点です。
初回の51.8点から37.7点上がり、Fable の89.8点に並ぶ水準まで届きました。
ただ、未達の項目もはっきり残りました。
目標にした動作時 CPU 6%以下は6.98%、100 fps の基準も59.97 fps で届きませんでした。
さらに6回目では CPU が4.56%まで下がった代わりに、クリック応答が165.4 ms へ悪化しています。
伸ばす指標を絞らないと、別の数字が崩れる癖も見えました。
最初の出力だけを見て「使えない」と切っていたら、私は Astra の本当の実力を見逃していました。
1 回目で諦めると見逃す、東京 3D の 3 周
同じ癖は、11月18日に試した東京の3Dモデリングでもはっきり出ました。
浅草の雷門まわりを歩ける3D地図にする課題で、Astra にあえて基準なしの1行だけを渡したのです。
「今持っている力を全部使って、この東京を写真に見えるまで仕上げて」
約10分で返ってきた1回目は、瓦の重なりなどは良くなったものの、まだ写真には見えませんでした。
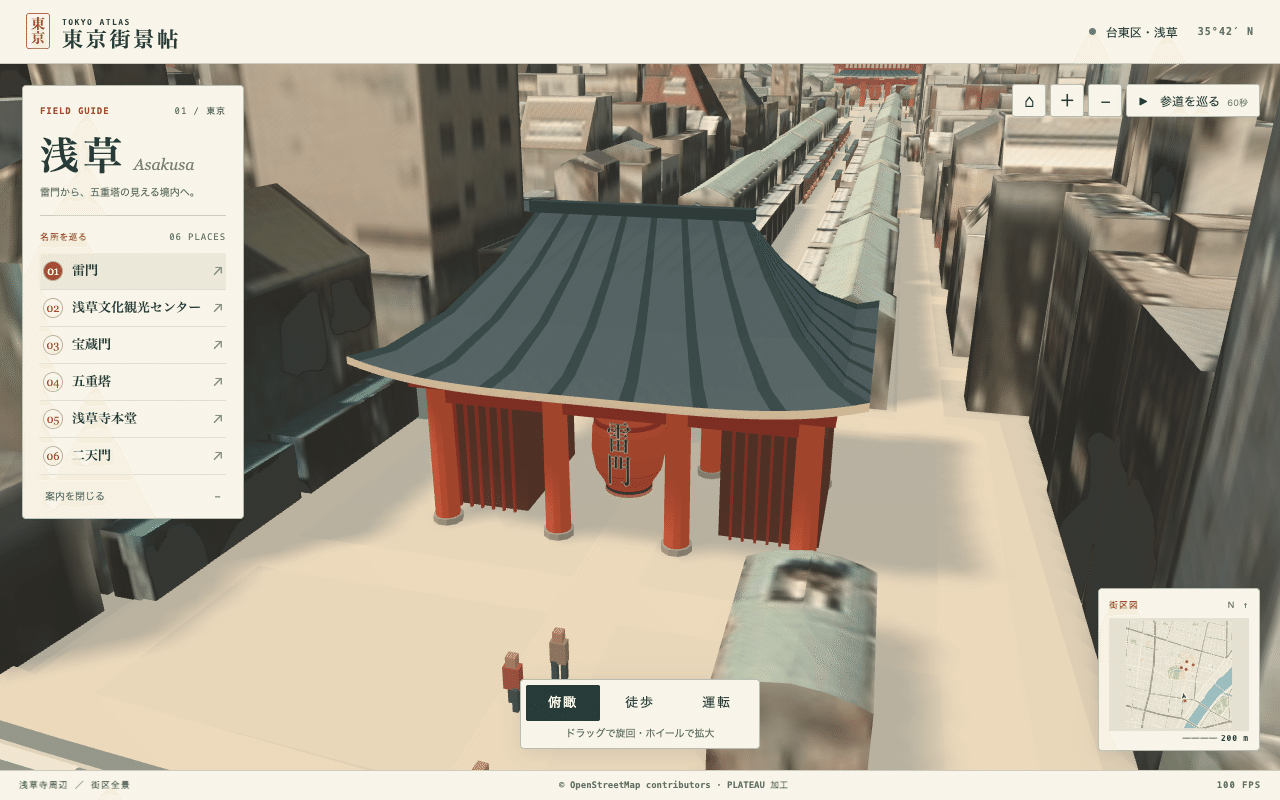
上の画像が、その段階の仕上がりです。
ここで打ち切らず、もう一周回させました。
すると約40分かけた2回目で、出力が一気に化けました。
Astra が自分で台東区の3Dデータ(PLATEAU)の実写テクスチャを探しに行き、雷門を作り直したのです。
そこで私は「もう一周回してみよう」と伝え、3周目には具体的な3つの基準を渡しました。
周囲のビルの側面を実写の素材にすること、本堂の足元の石段に影と汚れを入れること、人の姿勢を直すこと。
あわせて実写の雷門と並べた1枚を渡し、「まだ写真に見えない所を3つ正直に挙げて」と突き合わせています。
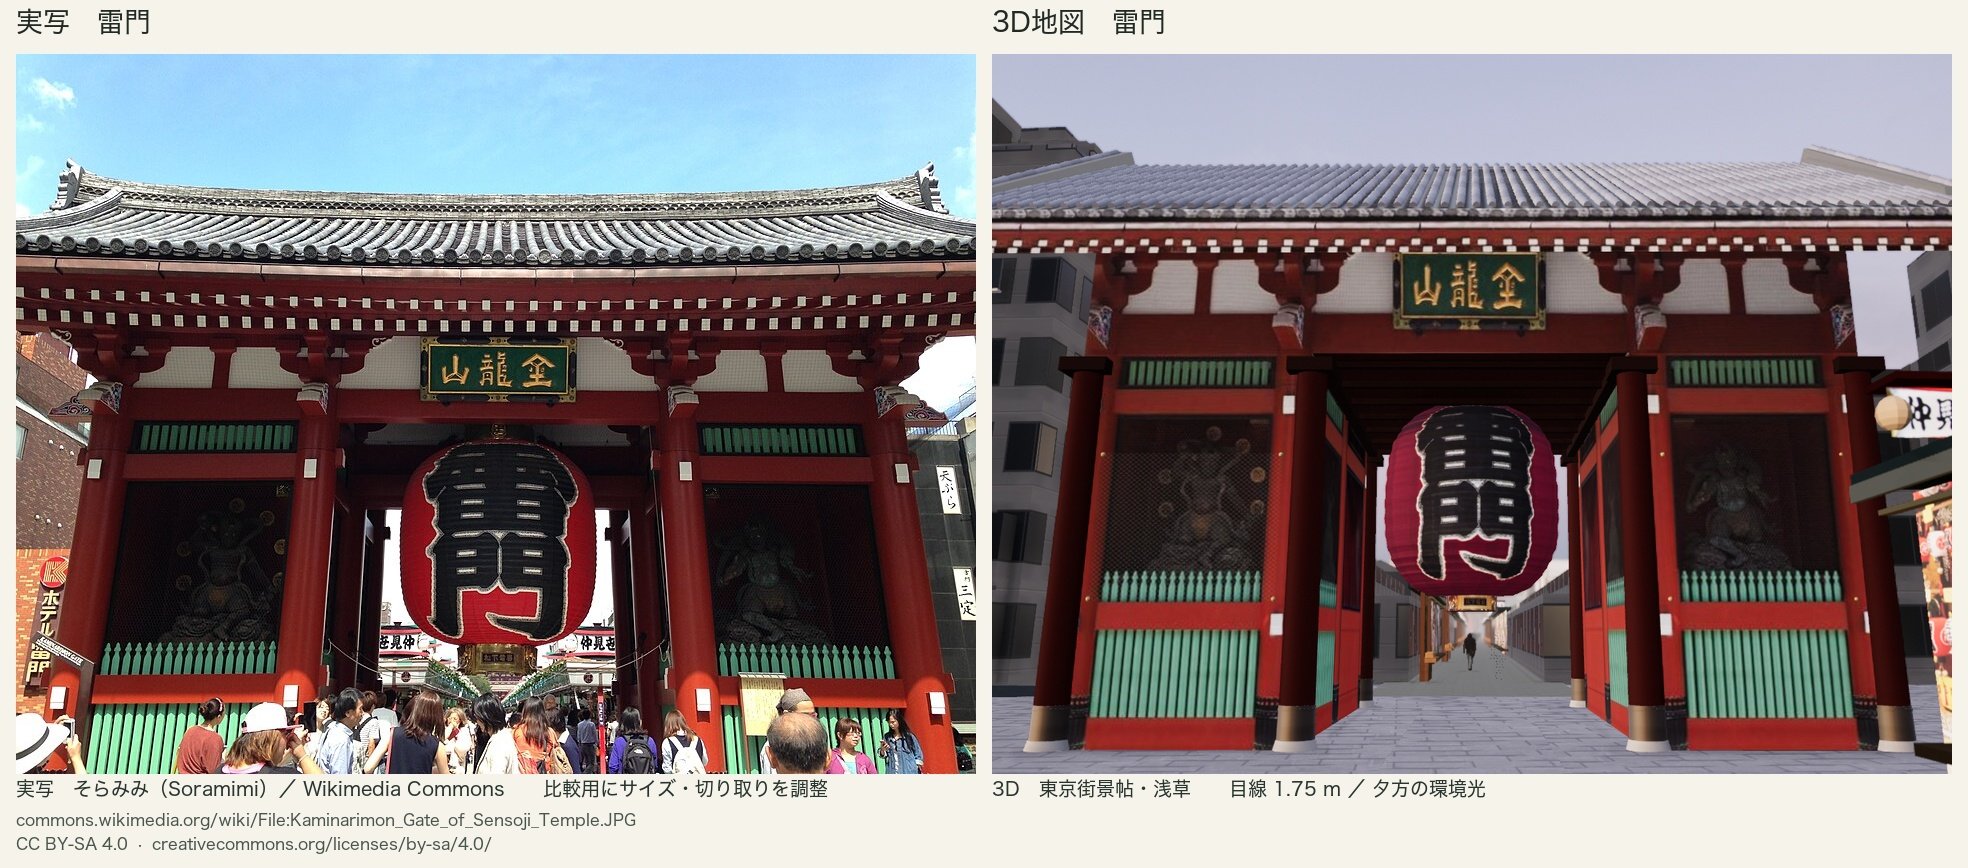
左の実写はそらみみ(Soramimi)氏撮影(Wikimedia Commons)を比較用にサイズ調整・合成しており、本比較画像も CC BY-SA 4.0 で公開します。
実写と並べて基準を詰めたことで、見た目の密度は1回目と別物になりました。
英語圏の X でも、Astra と Sol は「放っておくと途中で止まる」「細かく条件を渡すと別物になる」という声が目立ちます。
ただ、手抜きが消える理由は、プロンプトを長く書いたからと単純に言い切れません。
1回目で切らずに粘らせ、測れる基準や実写の写真という証拠を突き合わせて回したとき、Astra はがっちりやってくれます。
話しやすさは採用条件になる
では、なぜ私が普段のオーケストレーター役に Opus や Neon を選んでいるのか。
答えは、話しやすさです。
今週 Gemini 4 Neon を触っていちばん感じたのは、日本語がとにかく上手で、話しやすいことでした。
AGI Radar でも、Neon には「Opus の不自然な日本語と違い、自然な日本語を書く」という声が入っています。
日本語の自然さや監査での気づきが評価される一方、思考を上げすぎると深読みする癖も報告されています。
それでも、モデルが自分のワークフローに採用されるかは、話しやすさで決まると感じています。
Opus は雑な指示を投げても、こちらの意図を汲んでそつなくこなしてくれます。
対する Astra は、Theo 氏が「今年使った LLM で最も読み解けない出力」と書いたように、返答の分かりにくさが気になります。
曖昧な考えを壁打ちして形にしたい場面で、毎回返答を読み解く負荷がかかる相手は選びにくいのです。
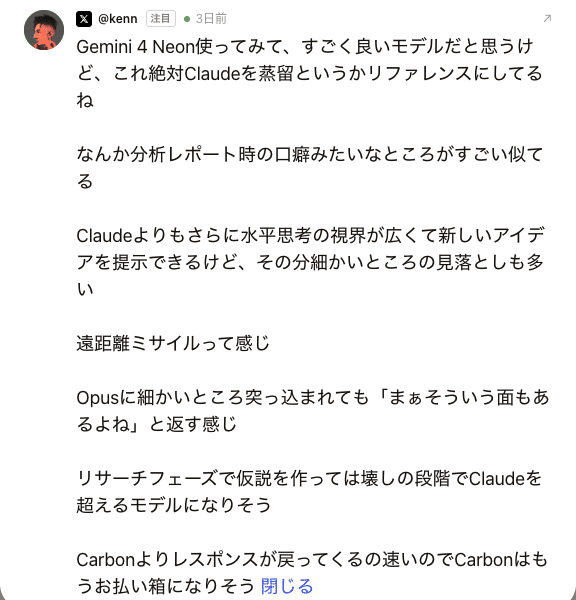
@kenn 氏も「仮説を作っては壊すリサーチ段階で Claude を超えそう」と書いており、壁打ち役としての手応えが重なります。
ベンチマークの表には載らない「話しやすさ」が、毎日いちばん最初に開く相棒を決めています。
だから Cockpit で発注を分ける
ここまで来ると、「適材適所で使い分けましょう」では足りません。
現場で本当に効くのは、自分のワークフローのどこで、どのモデルに何を渡すかという発注の設計です。
私はいま、仕事を3つの段階に分けています。
1つ目は、曖昧な思考を言語化して、合格基準を作る段階です。
ここには、話しやすくて雑な指示を汲んでくれる Opus や Neon を置きます。
2つ目は、数値や実写比較といった明確な基準が置ける実作業です。
ここには Astra を置き、合格条件と反復ループを渡してがっちりやり切らせます。
普段の速い実装や整理は、軽くて安い Sol に回します。
月200ドルの Pro プランでも使えるようになった Ultrafast を使うことも多いです。
MTG 前に突然発生したタスクを投げたり、この速さに慣れると普段の作業でもつい使いたくなります。
とにかく爆速なので、まだ使ったことがない方にはおすすめです。
3つ目は、出来上がった成果物の検証です。
作らせたモデル自身に採点させず、別スレッドで同じ計測スクリプトにかけて測り直します。
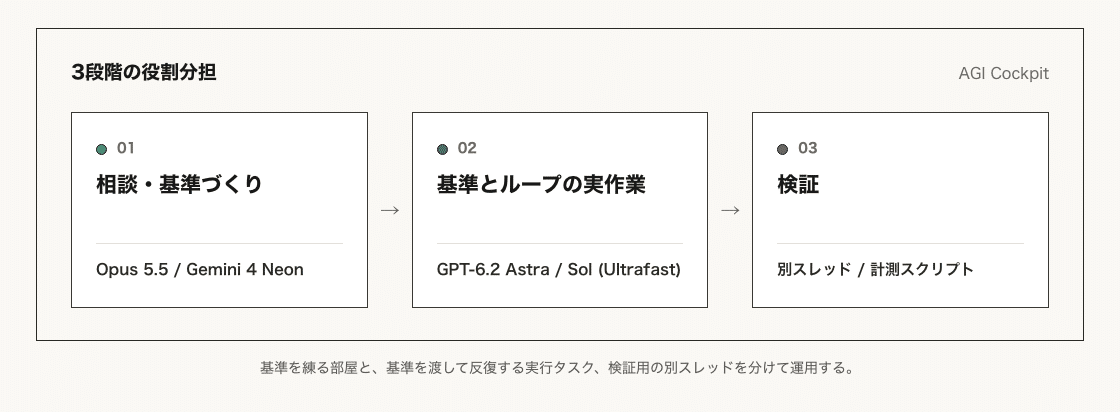
上の図のように役割を分けると、1つのチャット欄に1つのモデルだけを置く使い方では回りません。
相談して基準を練る部屋と、基準を渡してループで回す実行タスクを分け、途中経過をスマホからでも見られるようにする。
だからこそ、私は AGI Cockpit を使い続けています。
次に Astra や Sol に仕事を渡すとき、最初の返答だけで見限る前に、「何が揃えば合格か」を3つだけ書いて渡してみてください。
モデルの動き方が、そこから変わります。